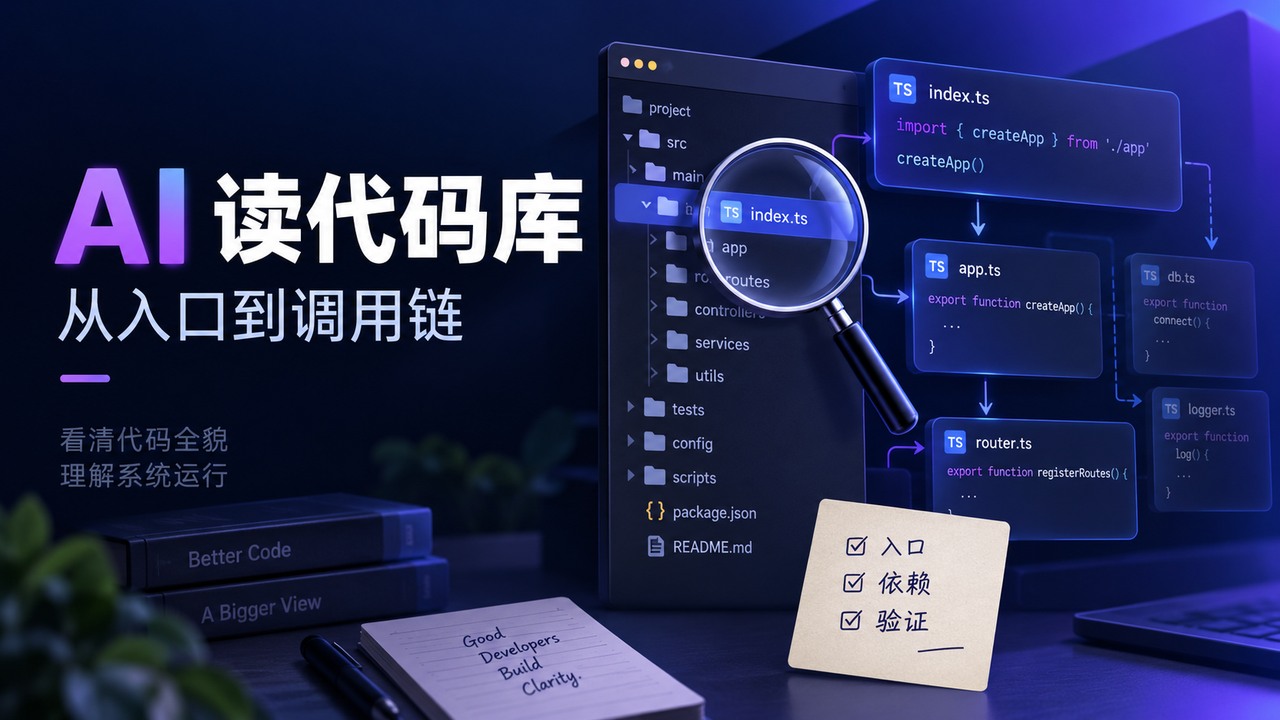
用 AI 读陌生代码库,最有效的起点是一条具体业务链,而不是让它一次概括整个项目。先确认项目如何启动,再从一个页面操作追到请求、处理函数和数据来源;每个结论都带文件路径与符号名称。墨刀 AI 客户端可以围绕本地项目文件辅助梳理,最终留下的应是一份能定位代码的接手笔记,而不只是漂亮的架构描述。
第一次接手项目,先回答这三个问题
面对几千个文件,按目录逐一解释很容易得到一份“src 放源码、utils 放工具”的无用总结。更有价值的是:怎样在本地看见它运行、一个用户动作在哪里处理、哪几处结论还没有证据。第一轮阅读只围绕这三个问题展开。
| 问题 | 应找到的依据 | 不要直接接受的答案 |
|---|---|---|
| 怎么启动 | README、依赖清单、锁文件、实际脚本与所需环境 | “这是 React 项目,运行 npm start” |
| 一条功能怎样工作 | 入口事件、请求路径、处理函数、数据读取及返回 | “前端通过 API 与后端交互” |
| 哪些还不知道 | 未读模块、外部服务、缺少配置与未运行环节 | “项目整体架构清晰、代码质量较高” |
README 可能过时,文件名也可能沿用旧叫法。把它们当导航线索,继续用实际脚本、导入关系和调用关系核对。看到 auth 目录,不能据此断言每个接口都做了鉴权。
第一轮:只建立运行与目录地图
先复制一份获准阅读的项目或切到不影响他人的工作分支。把生成目录、依赖缓存、构建产物与历史归档排除在首轮范围外;不要为了“让 AI 读完整”把整个电脑目录交给它。如果文件尚未整理,可以先用本地项目文件整理方法区分来源和输出。
我刚接手这个项目。请先只读,不修改文件,不安装依赖,不启动服务。
1. 查看根目录说明、依赖清单、锁文件与配置。
2. 列出项目类型、主要模块、已有启动/测试命令,并给出来源文件。
3. 区分源码、生成文件、测试、文档和外部依赖。
4. 标出启动还缺哪些环境变量或外部服务,只列变量名,不输出密钥值。
5. 不推测未读取的模块;先告诉我下一轮最值得阅读的 5 个文件。这一步的输出宜控制在一页。确认包管理器、项目脚本和环境要求之后,才考虑安装或运行。阅读目标是建立方向,不是顺手修复所有看到的问题。Claude Code 的代码库阅读指南同样采用先了解整体、再定位具体功能和执行流的顺序;具体工具入口可以不同,阅读方法可以通用。
第二轮:沿“成员筛选”追一条完整路径
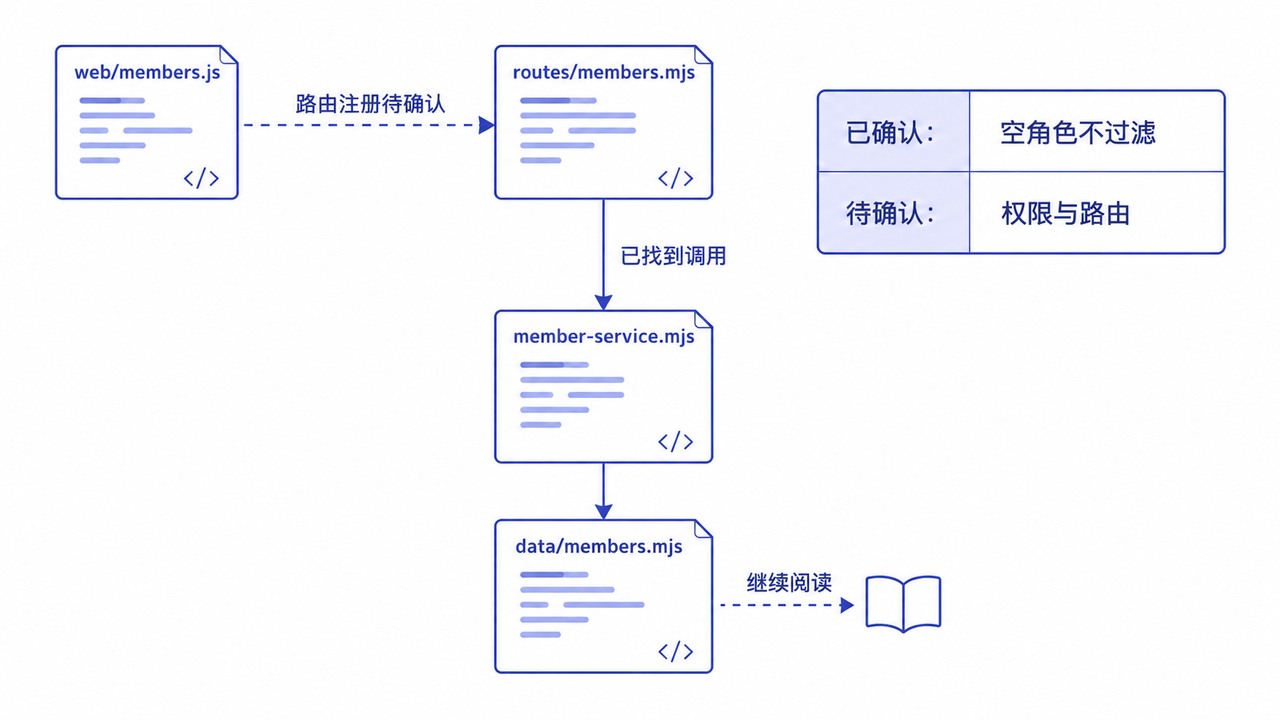
假设当前要接手成员管理页面。产品问题是:“选择角色后,名单为什么发生变化?”此时应找页面中的筛选操作,而不是从数据库模型开始漫游。下面这组简化文件帮助理解应该追踪哪些证据。
web/members.js               页面事件与请求
server/routes/members.mjs     请求处理
server/member-service.mjs     业务筛选
server/data/members.mjs       练习数据

// web/members.js 中的关键逻辑
const query = new URLSearchParams({ role: selectedRole });
const response = await fetch(`/api/members?${query}`);
const data = await response.json();
renderMembers(data.items);

// server/routes/members.mjs 中的关键逻辑
import { listMembers } from "../member-service.mjs";
export function handleMembers(query) {
  return { items: listMembers(query.role) };
}

// server/member-service.mjs 中的关键逻辑
import { members } from "./data/members.mjs";
export function listMembers(role = "") {
  return members.filter(member => !role || member.role === role);
}
这几段只展示阅读对象,并未提供完整服务器、页面和路由注册。因此可以确认函数内部的筛选规则,但不能仅凭它们声称 /api/members 已在真实服务器启用。阅读报告必须把这两种结论分开。
请追踪“成员页面选择角色后更新列表”这条路径。
先定位页面事件及请求代码,再找 /api/members 的路由注册、处理函数和数据来源。
每一跳给出文件路径、函数/变量名和对应代码依据。
区分:已经读到的直接调用、根据命名猜测、尚未找到的连接。
回答:角色为空时返回什么?筛选在前端还是后端?返回字段如何进入页面?
不修改代码,不设计新架构;缺少文件时直接列出缺口。| 位置 | 可以确认的结论 | 仍须核实 |
|---|---|---|
| web/members.js / fetch | 页面构造 role 参数,并读取响应中的 items | selectedRole 从哪个控件来;请求错误如何显示 |
| routes/members.mjs / handleMembers | 将 query.role 传给 listMembers | 实际 HTTP 路由是否注册到这个函数 |
| member-service.mjs / listMembers | 空 role 不限制,非空时按相等条件筛选 | 是否存在上游权限过滤或分页处理 |
| data/members.mjs | 需要继续打开才能判断数据结构 | 静态样本、缓存或真实数据访问不能只凭文件名断言 |
找定义之后,还要找谁调用它
AI 解释一个函数很容易,困难的是解释它在项目中的作用。同名函数可能存在于测试、旧版模块和生成文件中;调用方决定哪些参数真会传进来。读到 listMembers 后,继续找全部引用,并核对导入路径,而不是只搜到第一处就结束。
接手项目后若遇到运行期错误,可把同一请求的日志与调用链结合,按时间线定位业务返回和后续异常。
支持代码导航的编辑器或GitHub 定义与引用导航可以帮助交叉核对。搜索结果只是候选位置,实际导入、路由配置和运行路径才构成证据。
| 容易误读的情况 | 追加的阅读动作 |
|---|---|
| 同一函数在多个目录出现 | 检查当前模块的 import 路径,区分生产、测试和历史实现 |
| 文件名叫 API,实际使用静态数据 | 继续读取请求返回及数据加载处,不根据目录名判断 |
| 配置开启了功能,页面仍不显示 | 找功能开关、用户条件及组件渲染条件 |
| 一次搜索找不到接口 | 检查路由前缀、代理转发和动态注册,不宣布接口不存在 |
| AI 输出了行号 | 回到当前版本核对;行号会随修改变化,同时保留函数名 |
把阅读结果交成一份能接手的笔记
读完一条路径后,保存下面的结构即可。文件可以叫 project-reading-notes.md。它的作用是缩短下一位同事找代码的时间,不必画出全部模块关系。
# 项目接手笔记
## 阅读基线
仓库/分支或提交:填写实际版本
本次目标:成员列表角色筛选

## 启动
文档说明的命令:填写并注明来源
实际运行情况:已运行/未运行,缺少的环境

## 关键路径
页面事件 → 请求路径 → 路由注册 → 处理函数 → 数据来源 → 页面呈现
每一项附文件路径与符号名;没找到的写“待确认”。

## 已确认规则
例如:listMembers 中空 role 表示不过滤。

## 待确认
例如:路由注册与鉴权位置尚未阅读,不能判断权限覆盖。

## 下一轮阅读
只列与当前问题最相关的 3 项,不扩成全部技术债清单。
判断笔记是否合格,可以请同事据此定位三个位置:用户操作从哪里进入、规则在哪里生效、结果在哪里展示。若只能复述“采用分层架构”,却仍找不到代码,说明这轮阅读没有完成。
运行依据和调用路径确认后,可以继续按项目文件生成并验证README,把启动命令、所需文件和预期输出交给下一位同事,避免接手笔记里的结论又被过期说明覆盖。
什么时候该继续阅读,什么时候才开始修改
如果尚未确定实际调用路径,先补证据;如果已经定位行为与规则的差异,再把修改作为独立任务。例如“成员筛选为何返回这些人”属于阅读,“把角色与状态改成同时满足”属于改动。后者可按Vibe coding 小改动练习写清预期并运行验证。
遇到依赖外部服务、动态插件或缺失环境的项目,允许笔记留下“未运行”和“尚未确认”。这比根据目录补出一条貌似完整的调用链更利于接手。墨刀 AI 客户端的本地文件能力适合辅助这样的分轮阅读;你可以下载客户端,从一项自己需要理解的页面操作开始。
沿业务调用链读懂项目后,可以围绕一个具体变更继续做AI代码评审并验证问题输入;若代码在本地通过、流水线却失败,则转向比较CI日志与本地运行条件。前者检查变更引入的行为,后者定位同一提交在不同环境下的差异。