先给结论:墨刀AI客户端处理本地项目时,最重要的不是把更多文件放进文件夹,而是建立一个边界清楚、来源可追溯、结果可回滚的项目上下文。文件夹整理得越清楚,AI越容易知道哪些是事实、要完成什么任务、结果应该写到哪里。
一条稳妥的路径是:建立最小项目目录 → 标记事实来源 → 明确输出格式 → 先看中间产物 → 再把确认结果交给工作台。本文用“根据用户反馈整理预约功能 PRD 并生成可评审页面草稿”的任务,说明墨刀AI本地项目怎么用。
墨刀AI本地项目到底是什么
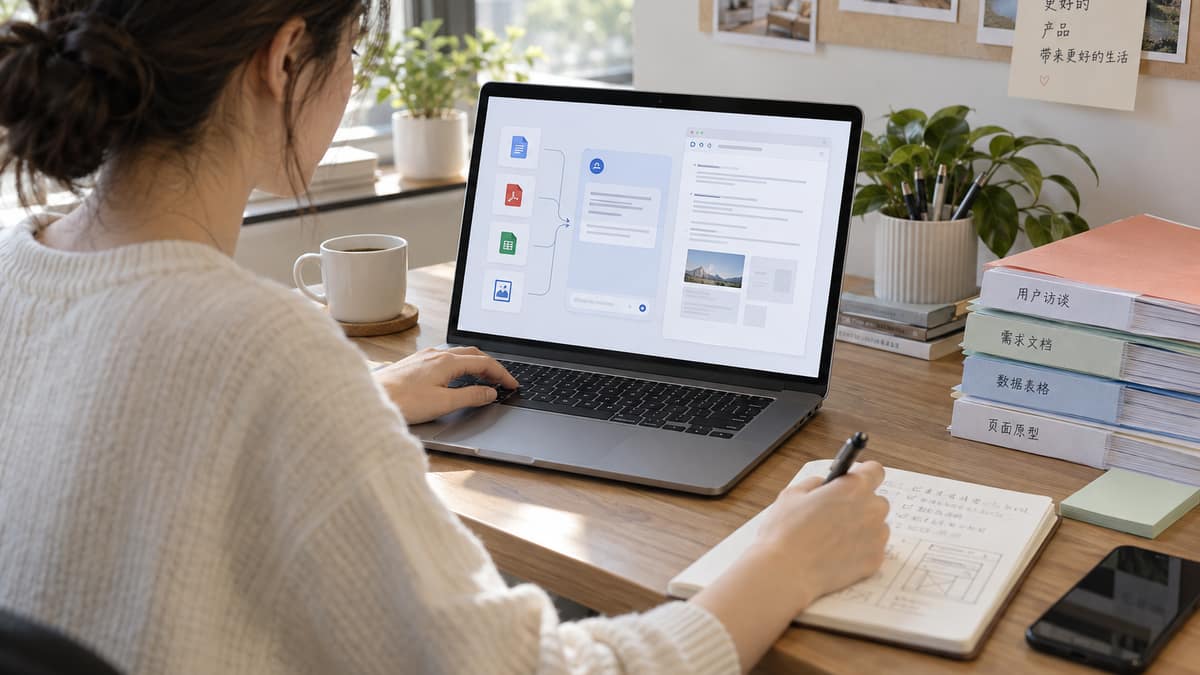
这里说的“本地项目”,是你在电脑上选定并打开的一个项目文件夹。AI客户端可以在这个范围内读取经过授权的文件,结合对话要求生成或修改文档、表格、HTML、代码和图片,并在工作区预览结果。它的基本单位不是一条聊天记录,而是一个可以持续处理的项目上下文。
这意味着同一项目中,文件名、目录结构、版本和说明文字都会影响 AI 的判断。如果把旧版PRD、临时截图、未确认数据和正式模板混在一起,AI 可能会把过期内容当成当前规则。建立本地项目的第一步,永远是划定“这次任务允许读取什么”。
客户端的安装、在线版和工作台入口区别,已经在墨刀AI客户端使用指南中说明。本文只深入本地项目的组织、处理和交接方法。
先建立最小可用文件夹,而不是打开整个资料盘
以预约功能为例,可以先建立这样的目录:
| 目录 | 放什么 | 作用 |
|---|---|---|
00_context | 需求背景、目标用户、范围和限制 | 说明本次任务为什么做、做到哪里 |
01_sources | 访谈、客服反馈、数据表、旧版流程 | 保存事实来源,尽量只放当前有效资料 |
02_working | AI生成的摘要、冲突清单、PRD草稿 | 允许反复修改的工作区 |
03_review | 评审版原型、评审记录、待决策清单 | 交给产品、设计、研发共同检查 |
99_archive | 旧版本和已废弃资料 | 保留历史,但避免被当作当前来源 |
目录名不需要完全照搬,关键是让“事实来源、正在生成的内容、已经评审的内容”分开。项目文件夹内还可以放一份 README.md,写明当前目标、负责人、有效版本、禁止修改的文件和输出位置。AI先读这份说明,通常比直接读取几十个散乱文件更稳定。
给资料加上来源、版本和可信度
AI能读到文件,不代表它知道文件是否可信。建议在文件名或目录说明中至少标记三个信息:
- 来源:用户访谈、客服系统、数据表、业务规则还是个人判断。
- 时间:资料对应的版本或采集日期,旧资料要明确写“历史参考”。
- 状态:已确认、待确认、仅供参考或已废弃。
例如,把 访谈记录.docx 改成 2026-09-18_用户访谈_已脱敏_原始记录.docx,把 旧PRD.docx 改成 PRD预约中心_v0.2_历史参考.docx。这不是为了让文件名更复杂,而是为了让人和AI都能快速判断它在当前任务中的地位。
让 AI 输出时也遵循同一规则:要求它把“原文事实、合理推断、需要确认”分成三栏,并在事实后标记来源文件。这样后续产品经理修改需求时,可以回到原始资料,而不是在一段流畅文字里猜哪些内容是AI补出来的。
第一次对话怎么写,才能让项目真正开始
不要只输入“帮我写一个预约功能PRD”。一条可复用的任务说明应包含范围、来源、输出、限制和检查方式:
| 任务字段 | 预约功能示例 |
|---|---|
| 目标 | 根据已脱敏访谈和客服反馈,整理预约改期功能的需求初稿 |
| 事实来源 | 只引用 01_sources 中标记为当前有效的文件 |
| 输出位置 | 摘要写入 02_working/evidence-summary.md,PRD写入 02_working/prd-v0.1.md |
| 结构 | 用户问题、目标、范围、流程、页面、异常、验收条件、待确认问题 |
| 限制 | 不改变支付流程;首期只讨论移动端;不补写没有来源的业务数字 |
| 检查 | 列出使用的文件、冲突内容和未确认假设,生成后不要覆盖源文件 |
在客户端中可以用“@”指定文件或资料,再补充上述要求。第一轮先生成证据摘要和冲突清单,不要急着同时生成最终原型。先确认输入理解正确,后面的页面和PRD才不会建立在错误背景上。
把一次任务拆成四个可检查的中间产物
AI生成本地项目结果时,建议按四段走,每段都留下文件:
- 证据摘要:每条结论附来源和时间,区分事实、推断与缺口。
- 需求模型:把问题转成用户目标、范围、流程、规则和验收条件。
- 页面草稿:根据已确认需求生成HTML、页面清单或原型方向,覆盖空、错、加载和成功状态。
- 评审包:整理版本、变更说明、待决策项和下一位协作者的任务。
客户端提供工作区预览和编辑能力,HTML、文本、代码和表格可以继续修改;项目使用Git时,还可以查看AI带来的差异。每段产物都独立保存,出现错误时可以只回退当前段,而不是把整个项目推倒重来。
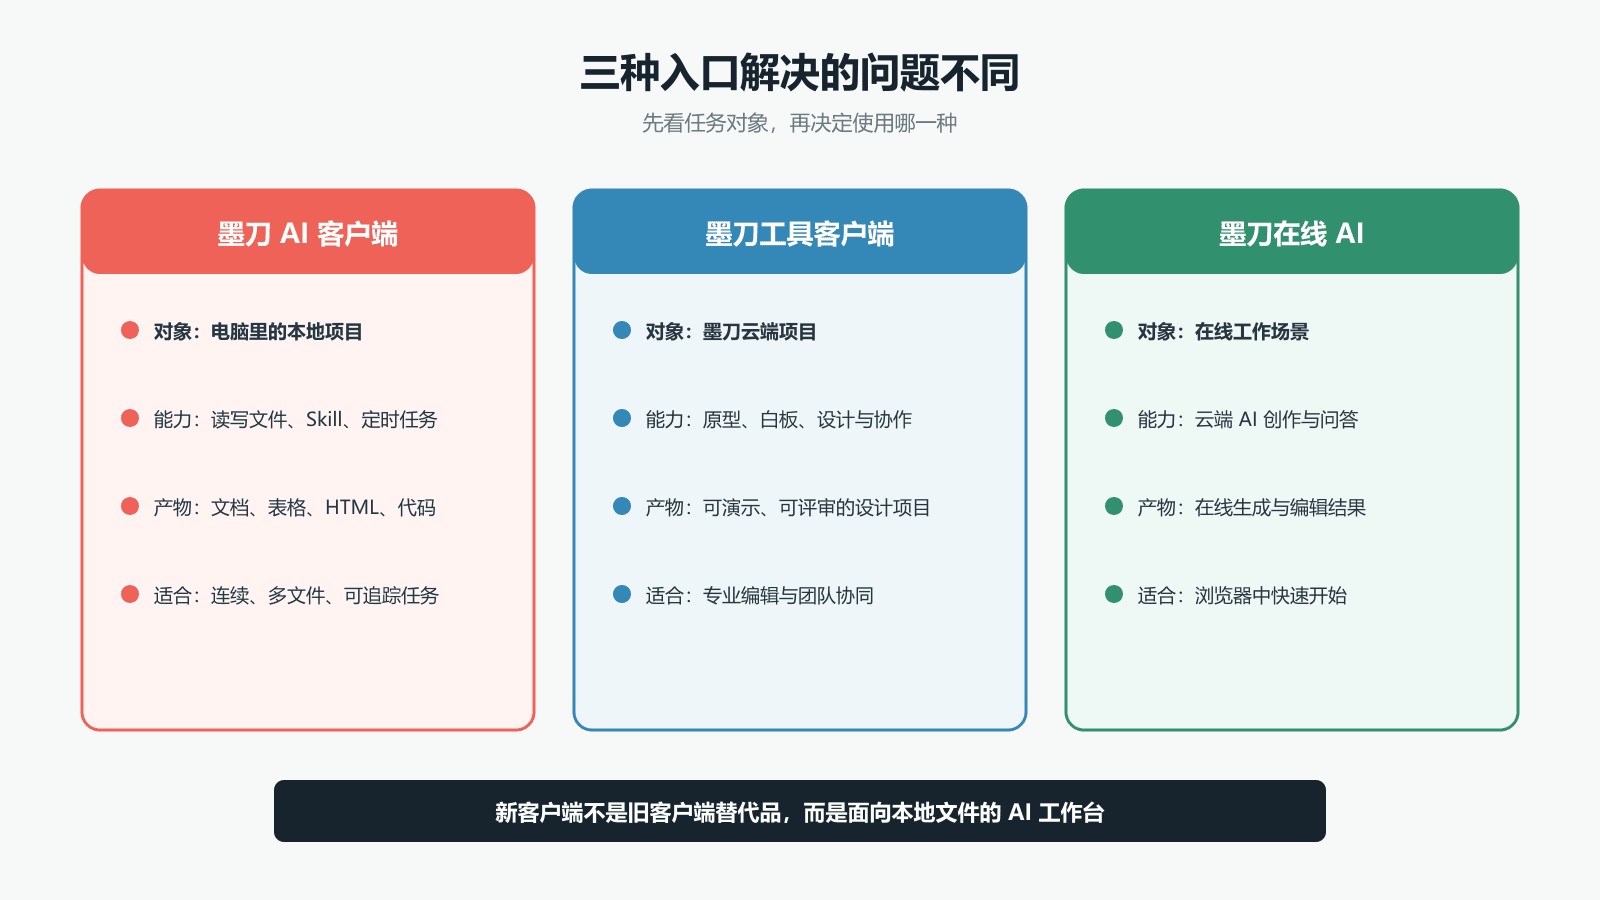
本地模式与云端模式怎么判断
选择模式时不要先问“哪个更强”,而要问“任务的主要对象在哪里”。
| 情况 | 更适合的入口 | 原因 |
|---|---|---|
| 文件夹里有多份访谈、Word、Excel、HTML和代码 | 本地项目 | 资料连续存在,减少重复上传和背景解释 |
| 只想把一句需求快速生成原型或方案 | 墨刀AI在线版 | 浏览器打开即可开始,适合短任务 |
| 需要多人评审、评论、版本和企业权限 | 墨刀工作台/企业空间 | 结果要进入团队正式协作边界 |
| 需要通过外部AI工具调用墨刀能力 | 评估MCP | MCP是连接方式,不等于本地项目上下文 |
本地项目并不意味着最终成果永远留在电脑里。更合理的路径是先在本地处理原始资料和草稿,确认后把可编辑、可评审的结果带入工作台;团队权限、项目归属和正式版本在企业空间中管理。关于三者协作,可阅读墨刀工作台、AI客户端和企业空间如何配合。
本地项目里的资料安全边界
“文件保存在本机”不等于“任何资料都可以直接使用”。开始前应做一次最小授权检查:
- 删除或脱敏账号、密钥、手机号、身份证号和未公开客户数据;
- 只打开当前任务所需目录,不要把整个电脑、共享盘或历史资料库作为项目根目录;
- 在
README.md中写明哪些文件只可读取、哪些文件允许修改; - 重要文件先复制或提交Git,避免AI修改后无法恢复;
- 进入企业空间前,再检查外部成员、公开链接和下载权限。
对高风险任务,要让AI先列出它准备读取和修改的文件,再决定是否继续。涉及生产配置、合同、财务、医疗或其他敏感场景时,应遵守组织制度和最新隐私说明,不把客户端当成自动审批工具。
从本地项目交给产品、设计和研发
本地任务完成后,不建议只把最终截图发到群里。至少交接四项内容:
| 交接内容 | 应包含什么 | 下一位协作者要做什么 |
|---|---|---|
| 结论 | 问题、目标、范围和事实来源 | 确认业务方向和优先级 |
| 页面/流程 | 主要路径、异常状态、页面清单和交互说明 | 在工作台继续编辑和评审 |
| 变更 | 新增、删除、未决和假设 | 决定是否接受或退回 |
| 版本 | 文件路径、版本号、负责人和评审时间 | 从同一基线继续工作 |
工作台更适合承接原型、白板、设计和团队评论,企业空间更适合管理成员、权限、版本和资产归属。这样交接,AI加速的是资料处理,团队保留的是决策权和可追溯性。
本地项目最常见的五个错误
- 目录过大:AI读取到大量无关旧文件,输出混入过期规则。解决:从最小项目文件夹开始。
- 源文件和草稿混放:下一轮任务无法判断哪个版本有效。解决:按来源、工作中和评审中分层。
- 只给目标不给格式:结果看似完整,却不能进入团队模板。解决:写出文件、章节、字段和输出位置。
- 只看最终答案:错误来源被隐藏,后续返工成本更高。解决:先看证据摘要、冲突和假设。
- 直接覆盖原文件:错误无法回滚。解决:复制、Git或版本目录先行。
墨刀AI本地项目检查清单
- 项目根目录只包含当前任务需要的资料。
- 每个事实来源都有版本、日期或状态标记。
- 已确认规则和AI推断没有混在同一段里。
- 输出文件有明确格式、目录和命名方式。
- 源文件有备份,AI变更可查看或回退。
- 页面草稿覆盖主要路径和异常状态。
- 交接包写明负责人、版本、待决策和下一步。
- 进入工作台或企业空间前重新检查权限和分享范围。
常见问题
墨刀AI客户端能读取整个项目文件夹吗?
它的设计就是围绕用户授权的项目上下文工作,但不建议因为“可以读取”就把整个资料盘交给AI。目录越大、旧版本越多,越需要先建立来源和范围规则。
本地项目一定要用Git吗?
不一定,但重要项目至少要有可恢复副本。若项目本来就使用Git,利用变更差异和提交记录会更容易检查AI修改;文档项目也可以用版本目录和日期命名实现基本回滚。
本地生成的HTML怎么进入墨刀工作台?
先在客户端预览和修改HTML,再根据团队需要导入、复制结构或使用墨刀AI在线版/工作台继续设计。具体导入方式取决于当前产品入口和文件类型,不能把本地文件自动同步当成默认能力。
团队项目应该放个人空间还是企业空间?
个人探索、未确认草稿可以先放在个人项目;涉及多人评审、权限、版本和正式交付的成果,应进入团队或企业空间,并明确负责人和访问范围。
墨刀AI本地项目的核心不是“把AI装进电脑”,而是把一项真实工作整理成可理解、可检查、可交接的项目上下文。先用一个小需求跑通资料、产物和交接,再逐步沉淀目录模板、Skill和企业空间规则,通常比一次打开所有文件更可靠。
下载墨刀AI客户端,从一个可回滚的真实项目开始。