Vibe coding 是用自然语言描述目标,让 AI 协助生成或修改代码的开发方式。要让一个小改动真正可用,先把输入、预期结果和不应改变的行为写清,再读代码差异、运行样本。下面以“成员列表按角色和状态筛选”为练习,提供可运行文件与五组检查输入。
如果没有边界和验证,Vibe coding 很容易变成“代码能生成,但没人知道改了什么”。本文给出一个适合产品、研发和设计协作的七步闭环,并说明怎样用墨刀AI客户端降低上下文切换和返工风险。
Vibe coding 到底是什么
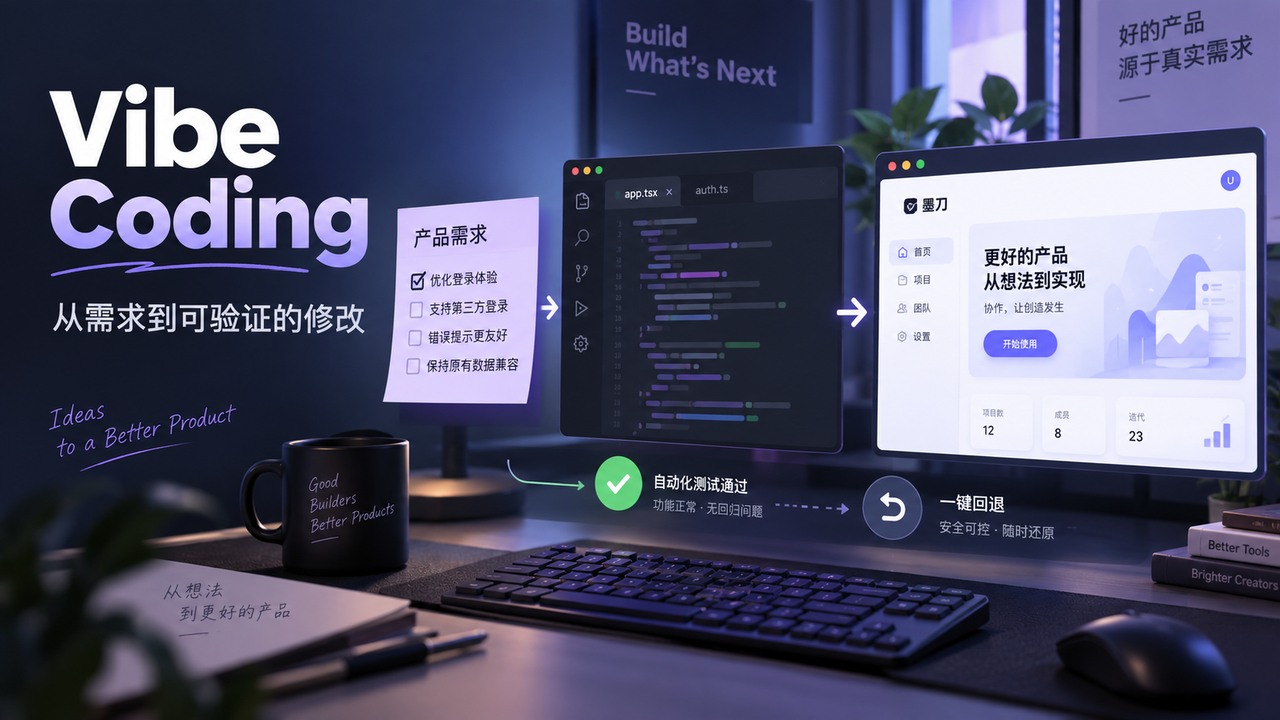
Vibe coding 可以理解为一种“目标驱动的自然语言开发”:人描述用户目标、约束和验收方式,AI结合项目上下文提出计划并完成局部实现,人再根据差异和运行结果做判断。它适合探索、样板、界面和重复性修改,也能辅助定位缺陷、补测试和整理文档。
它不等于放弃工程纪律。涉及权限、支付、数据迁移、性能、安全和生产操作时,必须保留分支、评审、测试、日志和回滚。墨刀AI客户端能帮你读取本地文件、整理任务和生成修改建议,具体操作仍以当前客户端界面、项目权限和团队工具链为准。
第一步:把本地项目变成可理解的工作区
开始前先选择一个最小项目目录,而不是把整个磁盘交给AI。项目根目录可以包含:
| 内容 | 作用 | 需要标明什么 |
|---|---|---|
| README或任务说明 | 告诉AI项目目标、启动方式和当前范围 | 目标、非目标、负责人、验证命令 |
| 源代码与配置 | 提供真实模块、依赖和入口 | 哪些文件只读,哪些文件可改 |
| 测试和样例 | 说明现有行为和判定条件 | 如何运行、哪些测试稳定 |
| 设计/需求资料 | 补充用户路径和界面约束 | 版本、状态、事实来源 |
| 变更记录 | 保留每次任务的计划、差异和结果 | 基线、日期、未决问题 |
本地项目如何分层、如何避免旧文件污染上下文,可参考墨刀AI本地项目怎么用。Vibe coding 的第一条规则是:AI先说明它准备读取哪些文件,再开始修改。
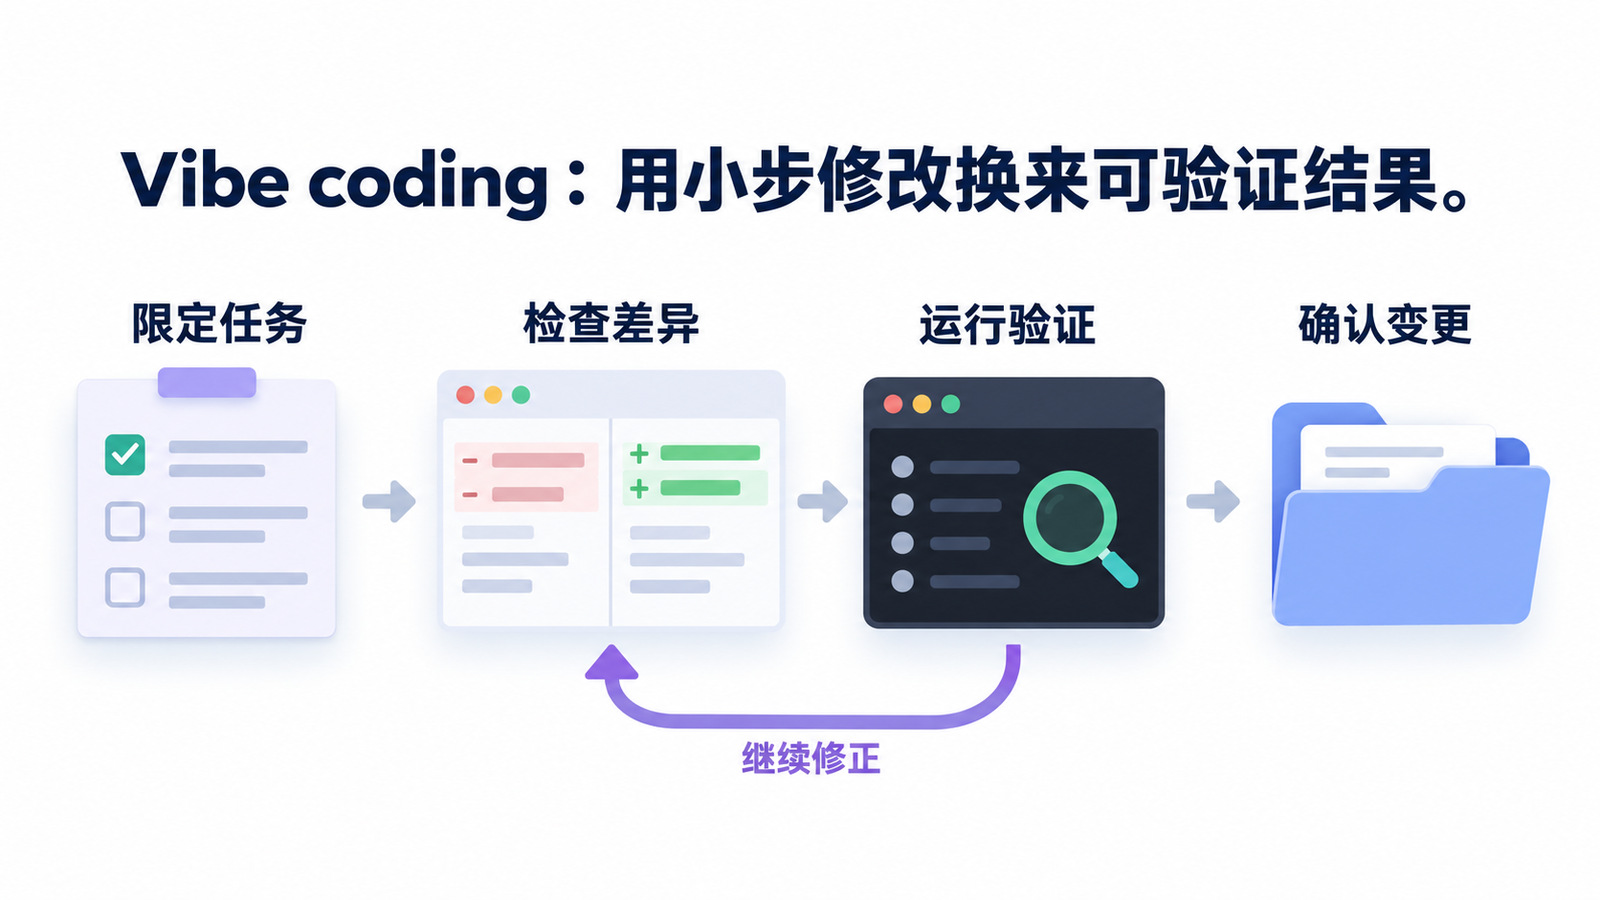
七步闭环:从目标到可合并变更
- 检查:读取目录、依赖、启动方式、Git状态和相关测试,列出不确定点。
- 计划:把任务拆成最小修改单元,写出目标文件、不会改的范围和验证方法。
- 实现:先做局部改动,保持命名、结构、错误处理和现有风格一致。
- 运行:运行最小可行的构建、格式化、静态检查或局部服务,记录真实输出。
- 测试:执行相关单测、接口或端到端用例,补充缺少的边界和失败场景。
- 审查:查看差异、依赖变化、权限影响、日志和性能风险,要求AI解释每一处改动。
- 交接:整理变更、验证证据、剩余风险和下一步,让产品、设计和研发在同一基线上继续。
每一步都应有一个可以保存的中间产物。这样即使下一步失败,也能回到上一个已确认状态,而不是重新猜测AI做过什么。
一条好的Vibe coding任务怎么写
自然语言越具体,AI越容易在正确范围内工作。推荐使用“目标、范围、约束、验证、输出”五段式:
| 字段 | 示例 |
|---|---|
| 目标 | 在管理后台增加成员筛选,支持角色和状态组合筛选,不改变现有分页语义。 |
| 范围 | 先检查成员列表页面、查询接口、类型和相关测试;只允许修改相关模块。 |
| 约束 | 保持现有组件风格,不新增依赖,不修改数据库结构,空筛选与旧行为一致。 |
| 验证 | 运行类型检查和成员筛选测试;补充无权限、空结果、重复参数和分页边界。 |
| 输出 | 先给计划和待确认问题,完成后说明改动文件、命令、结果和未覆盖风险。 |
不要把“看起来更好”“顺便优化一下”当作验收条件。审美、性能和重构都要拆成可观察的结果,否则AI会不断扩大任务范围。
如果任务只是拆开长函数、理清职责,可以按保持行为的AI代码重构方法先固定返回值、默认值和执行顺序,再比较前后结果,把结构调整与新增功能、修复旧问题分开。
跟着做:修好成员筛选中的一个逻辑错误
这个练习只用 JavaScript 和 Node.js,不依赖框架,也不访问网络。它代表后台页面里常见的组合筛选:角色与状态同时有值时必须同时满足,空条件表示不限制。界面长什么样不影响这条业务规则。
// 保存为 members.mjs
export const members = [
  { id: 1, name: '安然', role: 'admin', status: 'active' },
  { id: 2, name: '柏青', role: 'member', status: 'active' },
  { id: 3, name: '陈墨', role: 'member', status: 'disabled' },
];

// 初始版本:组合条件使用 OR,会误放行不匹配的成员。
export function filterMembers(items, filters = {}) {
  return items.filter(item =>
    (!filters.role || item.role === filters.role) ||
    (!filters.status || item.status === filters.status)
  );
}
把下面这条任务交给已打开练习目录的墨刀 AI 客户端。先要求它解释失败原因,再改这一处函数;不需要生成整套管理后台。
请读取 members.mjs,只修正 filterMembers。
规则:空条件不过滤;角色与状态同时给出时必须同时满足;保留输入顺序;不修改原数组。
先用 admin+active、member+active、仅 disabled 三种条件解释当前函数会返回什么。
然后做最小修改,不改成员数据,不引入依赖,不改函数签名。
给出差异和检查结果;若不能运行,明确说明并保留运行命令。| 过滤条件 | 预期成员 ID | 主要检查 |
|---|---|---|
| 空对象 {} | 1、2、3 | 没有筛选时保留全部 |
| role='admin', status='active' | 1 | 两个条件同时成立 |
| role='member', status='active' | 2 | 不能让 disabled 成员混入 |
| status='disabled' | 3 | 另一条件为空不能导致全放行 |
| role='owner' | 空数组 | 无匹配时不能退回全量 |
最小修正是把两组条件间的逻辑或 || 改为逻辑与 &&。每组内部仍保留“未指定该条件,或该字段匹配”的判断。
export function filterMembers(items, filters = {}) {
  return items.filter(item =>
    (!filters.role || item.role === filters.role) &&
    (!filters.status || item.status === filters.status)
  );
}
在同一目录保存 members.test.mjs。检查内容来自前面的业务规则,不是简单复制实现。
import assert from 'node:assert/strict';
import { members, filterMembers } from './members.mjs';
const cases = [
  [{}, [1, 2, 3]],
  [{ role: 'admin', status: 'active' }, [1]],
  [{ role: 'member', status: 'active' }, [2]],
  [{ status: 'disabled' }, [3]],
  [{ role: 'owner' }, []],
];
const before = JSON.stringify(members);
for (const [filters, expected] of cases) {
  assert.deepEqual(filterMembers(members, filters).map(x => x.id), expected);
}
assert.equal(JSON.stringify(members), before);
console.log('5 组筛选通过;原数组未改变');
node members.test.mjs
# 预期输出:5 组筛选通过;原数组未改变本文配套代码已在独立 Node.js 环境验证:初始函数不能通过组合筛选检查,修改后五组输入及原数组检查通过。这只证明这个小函数符合样本规则,不等于真实项目的权限、接口、页面交互和部署已经通过。把函数接入页面后,还要确认切换条件与清空条件是否正确刷新列表。
遇到失败时,把“输入是什么、实际返回什么、期望是什么”发给 AI,比说“还是不对”更容易定位。例如:“仅 status=disabled 应返回 ID 3,实际返回 1、2、3,请检查空 role 对条件组合的影响。”
为什么要小批量修改
一次让AI重写多个目录,短期看似高效,实际会让差异难以审查,测试失败也难以定位。更稳妥的节奏是:
- 先完成一个用户路径或一个接口,不同时改无关模块。
- 每次修改后查看差异和运行结果,再决定是否继续。
- 把“必须完成”和“可以顺便做”分开,后者另起任务。
- 发现需求或代码理解错误时,先停止并更新上下文,不要用更多提示词掩盖。
小批量不是限制AI,而是让每次结果都能被人理解。对于产品经理或设计师参与的任务,短小的变更卡也更容易在工作台中评论和确认。
用差异和证据审查,而不是凭感觉接受
审查AI修改时,至少看五件事:
| 审查项 | 要确认什么 |
|---|---|
| 功能差异 | 是否只完成任务范围,是否改变了既有行为 |
| 数据与权限 | 是否新增越权、敏感字段、默认权限或数据丢失风险 |
| 错误处理 | 超时、空值、重复、下游失败和回滚是否有明确行为 |
| 依赖与性能 | 是否新增包、网络调用、循环查询或不可观测的慢路径 |
| 验证证据 | 执行了哪些命令、测试是否真实通过、哪些仍未验证 |
要求AI输出“修改前后的行为差异”和“未验证假设”,比只让它总结代码更有用。若项目使用Git,先在分支或可恢复副本中工作,确认差异后再合并;不要直接覆盖生产文件。
让Vibe coding和测试形成闭环
AI写完代码后,测试不应是最后才想起来的一步。任务开始时就把验收条件写入提示词,让AI先找到已有测试,再补充缺口。测试点可以按下面几类组织:
- 主流程:有效用户和有效数据能完成目标。
- 边界:空值、最大长度、极小或极大数量、时间边界和分页边界。
- 失败恢复:下游错误、超时、重复请求和重试后的状态。
- 权限安全:未登录、无角色、跨团队访问、敏感数据回显。
- 兼容回归:旧页面、旧接口、历史数据和不同设备的行为。
关于从项目文件生成测试点和执行清单,可继续阅读用 AI 生成与审查测试用例。测试结果要记录真实命令和证据,不能把AI的“应该通过”当作测试通过。
产品、设计和研发如何一起使用Vibe coding
Vibe coding 不只属于工程师。产品可以提供目标、流程、状态和验收条件;设计可以提供页面、组件、文案和交互边界;研发负责代码结构、依赖、性能、安全和发布。AI负责把这些输入整理成计划、草稿和局部变更,但每个角色仍要在自己的专业边界内确认。
一个可行的交接包包括:需求版本、页面或流程链接、任务范围、变更文件、运行命令、测试证据、截图或预览、未决问题和下一位负责人。需要多人评论、版本和企业权限时,把确认后的产物放入墨刀工作台与企业空间管理。
它和其他AI编程工具的关系
市场上不同工具都在把自然语言、项目上下文和代码执行连接起来。Qoder官方文档把本地项目、任务目标、执行模式和验证步骤作为快速开始的一部分;这说明“先给项目边界,再定义结果和验证”已经成为这类工具的共同工作方式。墨刀AI客户端的差异化重点,应放在产研设协作、原型和文档产物的衔接,以及本地任务与工作台之间的交接,而不是简单比较谁能生成更多代码。
无论使用哪种工具,都要保留同一套工程底线:最小权限、可回退分支、可复现命令、自动化测试和人工代码审查。工具名不能替代验证流程。
本地操作的安全边界
- 只授权当前任务所需的文件夹,不把密钥、客户数据和生产配置放入上下文。
- 涉及删除、迁移、发布或外部网络请求时,先让AI说明影响和命令,再由人确认。
- 将生成代码放在分支或副本中,保留变更差异和回滚方式。
- 对第三方依赖、脚本和命令逐条检查来源、权限和副作用。
- 生产环境操作遵守组织审批和发布制度,不把本地客户端当作审批系统。
Vibe coding任务上线前检查清单
- 目标、范围、非目标和验收标准明确。
- AI读取的目录、文件和版本已确认。
- 修改集中在任务范围内,没有无关重构。
- 类型检查、构建、单测、接口或端到端测试已真实运行。
- 边界、权限、错误恢复和兼容场景已覆盖。
- 差异、依赖、数据和性能风险有人审查。
- 未验证假设、已知缺陷和回滚方式已记录。
- 交接材料包含版本、证据、链接和负责人。
常见问题
Vibe coding适合生产项目吗?
它适合生产项目中的局部、可审查任务,但不适合跳过分支、测试、评审和发布制度。越接近权限、数据和生产操作,越需要缩小范围并增加人工门槛。
产品经理不会写代码,也能参与吗?
可以从目标、用户路径、状态、验收和待确认问题开始;让研发补充技术约束和验证命令。产品不需要替代研发做实现判断,但应该参与确认“做什么”和“怎样算完成”。
AI生成代码后,为什么还要自己看差异?
因为生成结果可能包含超出范围的改动、隐式依赖或错误假设。差异是最直接的审查入口,配合测试和运行日志才能判断它是否真的解决了问题。
如何避免Vibe coding变成无休止的对话?
每次任务都设置明确输出、验证命令和停止条件。完成一个可验收的小步骤后再开始下一步;遇到冲突或缺口先停下来补事实,不要用更多描述掩盖不确定性。
Vibe coding真正提升的是从想法到可验证变更的速度,而不是取消工程责任。用墨刀AI客户端把项目上下文、自然语言任务、局部修改和验证证据放在同一条链路里,产品、设计和研发才能共同看懂结果。需要开始本地任务时,可先下载墨刀AI客户端。
延伸阅读
- Git diff 官方文档:查看工作区、暂存区或两个版本的差异,帮助确认本次实际改动。