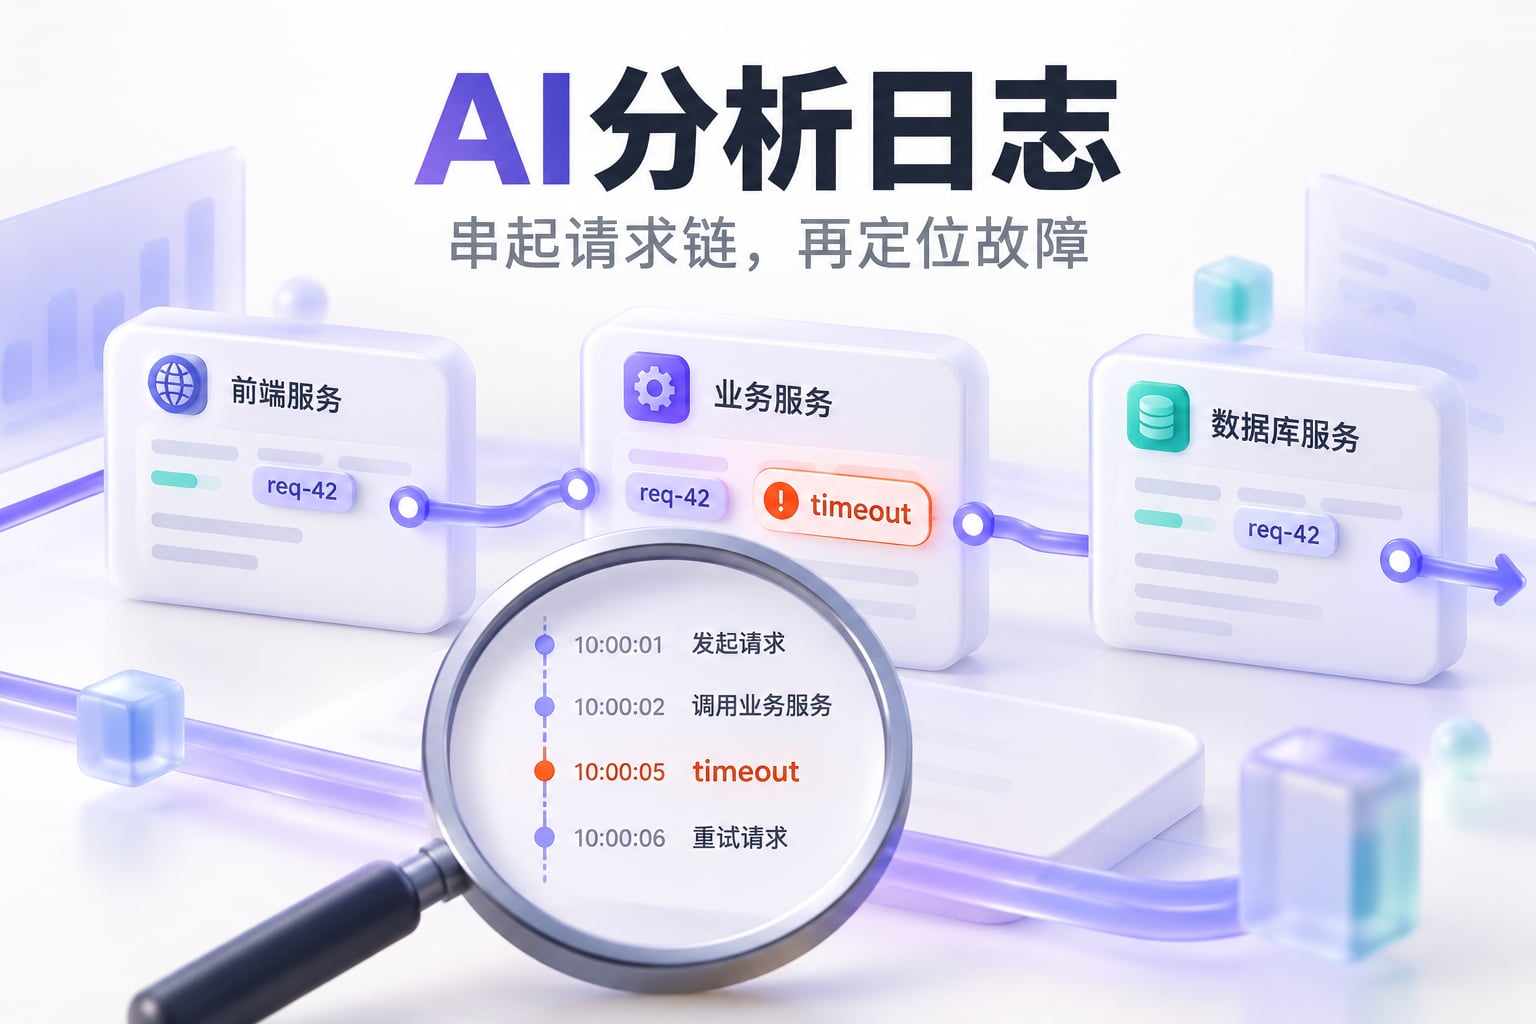
用AI分析日志,先圈定一次失败请求,再按请求标识、服务、时间和代码位置重建经过。不要只把最后一行报错交给模型猜原因:最显眼的错误可能是前面某个业务结果没有被正确处理。有效的输出应包括已经发生了什么、最有依据的原因、还缺什么材料,以及下一步怎样验证。
日志文件与项目代码都在电脑里时,可以用墨刀AI客户端分析本地项目资料,把脱敏日志、相关模块和排查笔记放进同一个项目。先限定为读取和解释,等问题范围明确后再讨论改动,避免一上来同时修改多处配置。
先给AI一个能够调查的问题
“帮我看看日志有没有问题”通常太宽。可以改成:“订单提交在10:14左右返回500,请只分析请求r-order-17经过网关、订单和库存服务的过程,找到可验证的异常处理问题。”这句话同时限定了用户动作、观察时间、请求范围与预期结果。
第一次提供资料,不必交出一整天的所有日志。先准备故障前后的一小段时间窗,保留同一请求的正常步骤,再附上一条相近条件下的成功请求作对照。只留下ERROR行,反而可能删掉因果链需要的上下文。
- 日志:保留原时间、时区、服务名、请求或链路标识、错误码和必要业务状态。
- 代码:对应的请求入口、被调用服务封装与错误处理函数。
- 变更:故障前后的部署版本、相关改动与配置变更名称。
- 现象:用户看到了什么、是否每次发生、影响哪个范围。
脱敏时不要把所有用户编号或请求编号都替换成同一个“XXX”。可以稳定映射为user-01、request-01,让同一对象在不同文件里仍能对应;凭证、令牌和无关个人信息则移除。具体数值若与故障相关,保留类型、单位和必要关系即可。
串日志之前,先解决时间和关联问题
OpenTelemetry日志数据模型区分事件发生时间与采集系统观察时间,并提供TraceId、SpanId等链路关联字段。项目不一定使用这套字段名,但排查时仍要弄清楚每个时间和标识实际代表什么。
同一行可能同时出现应用时间、容器时间和采集时间。将UTC与北京时间直接按字符串排序,或把日志到达采集平台的先后当作程序执行顺序,都可能拼出错误故事。跨机器还要考虑时钟偏差,毫秒级先后应结合调用关系判断。
请求ID也不总能贯穿全部系统。异步任务可能换成任务ID,重试可能产生新的请求记录。遇到缺口,让AI标明“这两条尚不能确认属于同一次请求”,再找任务关联字段;不要仅凭时间接近就连线。
订单返回500,最早的异常不一定是根因
下面是一组便于练习的简化日志,时间均为同一时区,request字段相同:
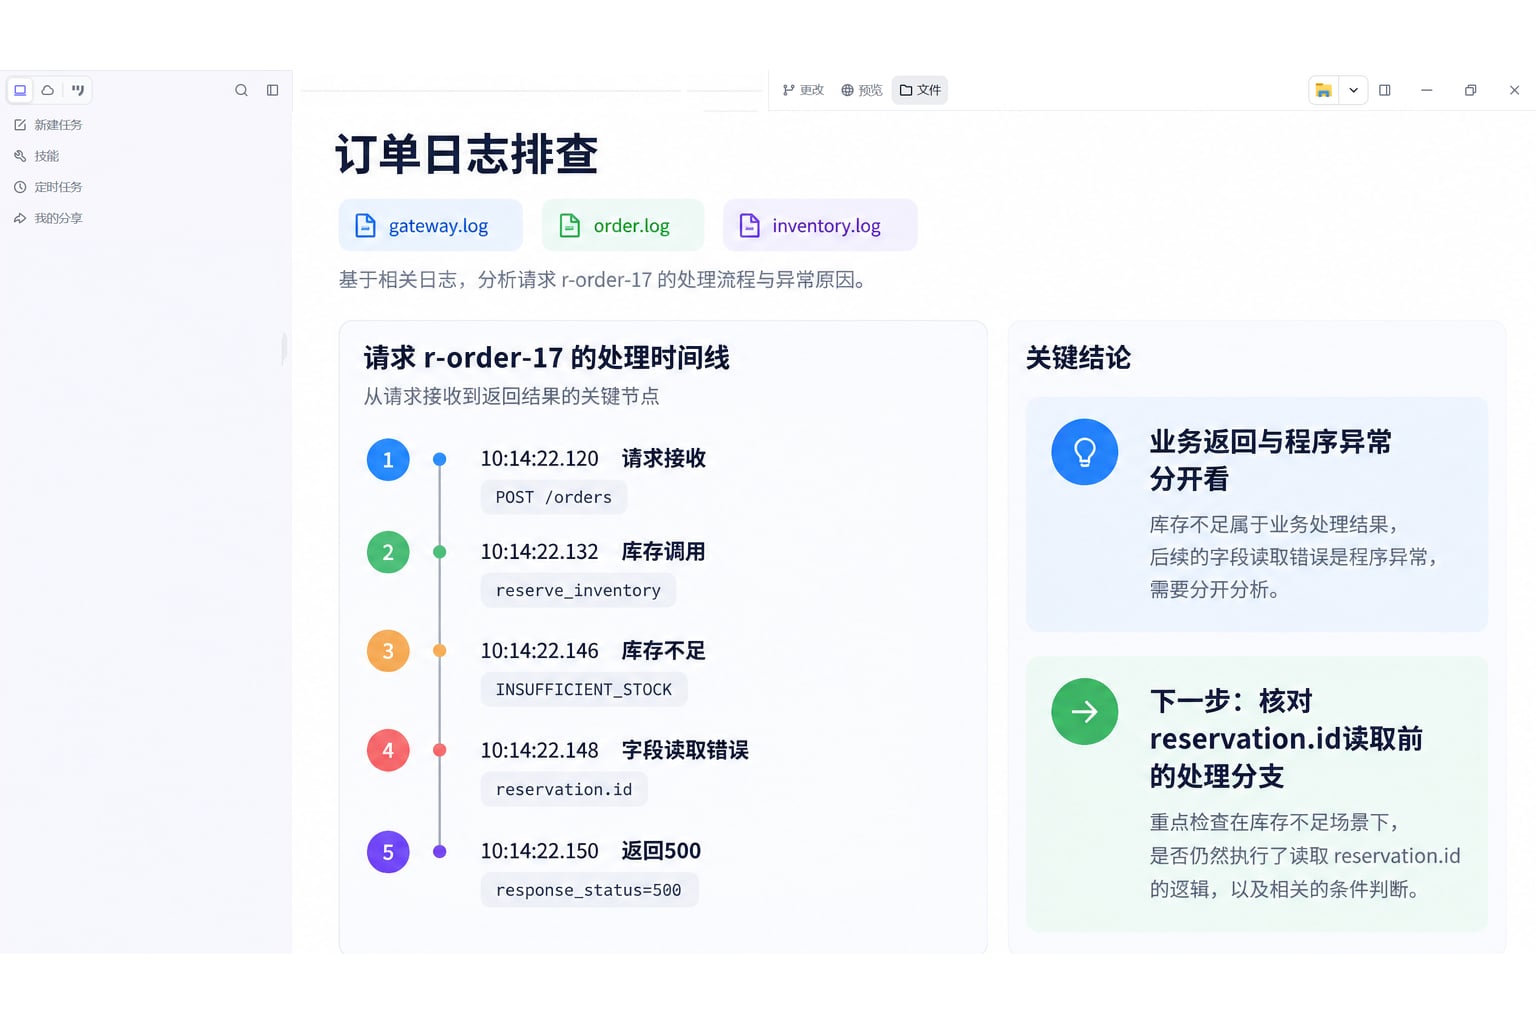
10:14:22.120 gateway   INFO  request=r-order-17 POST /orders received
10:14:22.132 order     INFO  request=r-order-17 reserve_inventory started
10:14:22.146 inventory WARN  request=r-order-17 code=INSUFFICIENT_STOCK
10:14:22.148 order     ERROR request=r-order-17 TypeError reading reservation.id
10:14:22.150 gateway   ERROR request=r-order-17 response_status=500
可以直接确认的是:这段记录里,库存服务先返回库存不足,随后订单服务出现属性读取错误,网关最终返回500。不能直接得出“库存数据库故障”或“增加机器就能解决”。库存不足本身可能是正常业务分支,真正需要追踪的是订单服务为什么仍然读取成功结果中的字段。
| 判断 | 当前依据 | 下一步查什么 |
|---|---|---|
| 500是用户看到的最终结果 | 网关响应状态 | 网关是否改写了上游状态或响应内容 |
| 订单服务可能未正确处理库存不足 | 库存不足之后发生reservation.id读取错误 | 读取位置的代码、reserve_inventory返回结构与分支 |
| 库存不足是否符合实际 | 只有一条业务错误码 | 相关库存记录、扣减规则、并发时的处理结果 |
| 数据库连接失败 | 这段日志没有支持材料 | 先不要据此修改连接配置 |
这里的价值是把“业务条件”和“程序缺陷”拆开:库存不足需要给用户明确反馈,字段读取错误则需要定位到具体代码分支。两者相关,却不应被合并成“库存系统坏了”。
分两轮提问,比一次要求“修好”更稳
先让AI按记录复原过程,不急着给修复方案。可以将以下任务直接交给客户端,并引用相应文件:
请只读排查资料,不修改代码,不访问生产系统。
目标:解释请求r-order-17为什么返回500。
读取:脱敏后的gateway.log、order.log、inventory.log。
1. 说明时间字段与时区,按请求标识整理事件表。
2. 每条结论注明文件名、行号和日志原句。
3. 区分业务返回、程序异常和最终响应。
4. 缺少关联字段或存在时间矛盾时明确标出。
5. 给出最多3个有依据的原因候选,写出能推翻各候选的材料。
本轮只输出时间线与下一步需要读取的文件。看到第一轮输出后,再指定读取订单服务的处理代码。如果对项目不熟悉,可先按沿业务调用链阅读代码的方法找入口和调用方,别让AI仅凭文件名断言某段代码正在运行。
请继续读取库存调用封装和订单创建函数。
核对INSUFFICIENT_STOCK在返回对象里怎样表达,
以及reservation.id读取前是否处理了非成功结果。
把源码中已确认的分支与日志时间线对应起来。
提出最小改动建议和需要补的测试,暂不修改文件。
不要把“当前日志没出现”写成“系统不可能发生”。
第二轮应留下具体文件与分支,例如“成功结果才有reservation;失败结果应进入业务提示分支”。如果函数版本与线上部署版本不一致,就应先找对应版本,不能拿最新代码解释历史故障后直接宣布已定位。
怎样证明修复的是问题,而不是症状
对上面的订单问题,至少覆盖库存充足、库存不足和库存服务不可达三种情况。预期结果应分别是成功创建、给出清楚的业务反馈、给出可重试或稍后处理的错误状态;具体HTTP状态和前端文案要遵循项目已有约定。
如果只是用可选链让reservation.id不再抛异常,程序可能继续保存一个缺失库存凭据的订单。错误日志变少,不代表业务变正确。应同时检查订单是否创建、库存是否占用、响应是否符合约定,以及重试会不会重复产生记录。
需要把这些分支落为断言时,可继续参考从已有代码生成单元测试。本地验证通过后,再按团队的测试与发布流程处理,保留故障样本供后续回归。
排查笔记怎样交给下一位同事
最后保存一份简短的调查记录:现象与影响范围、对应版本、关键时间线、已确认原因、仍未解释的现象、修改位置和回归结果。把日志片段和代码定位放在结论旁边,接手者就不必重新猜测判断来自哪里。
在墨刀AI客户端中持续补充同一项目的材料时,建议将原始脱敏日志与整理后的调查笔记分开存放。下一次相似报错出现,可以比较两次请求路径,而不只是问AI“是不是又发生同一个问题”。