用AI生成单元测试,最容易出现的问题是:测试和实现一起写错,却仍然全部通过。要避免这种情况,先把函数应该遵守的规则写成独立的输入与预期结果,再让AI读取现有代码和测试约定,生成可以真正执行的测试。评价产物时,除了看它能否通过,还要看规则被破坏时它会不会失败。
如果代码、需求说明和历史测试已经放在本地项目中,可以用墨刀AI客户端读取代码与现有测试,先整理行为约定,再补充测试文件。现有项目用什么测试框架、如何安装依赖和运行测试,都应延续项目本身的约定;不要因为AI熟悉另一套工具就顺手替换。
先约定行为,别让实现替自己出题
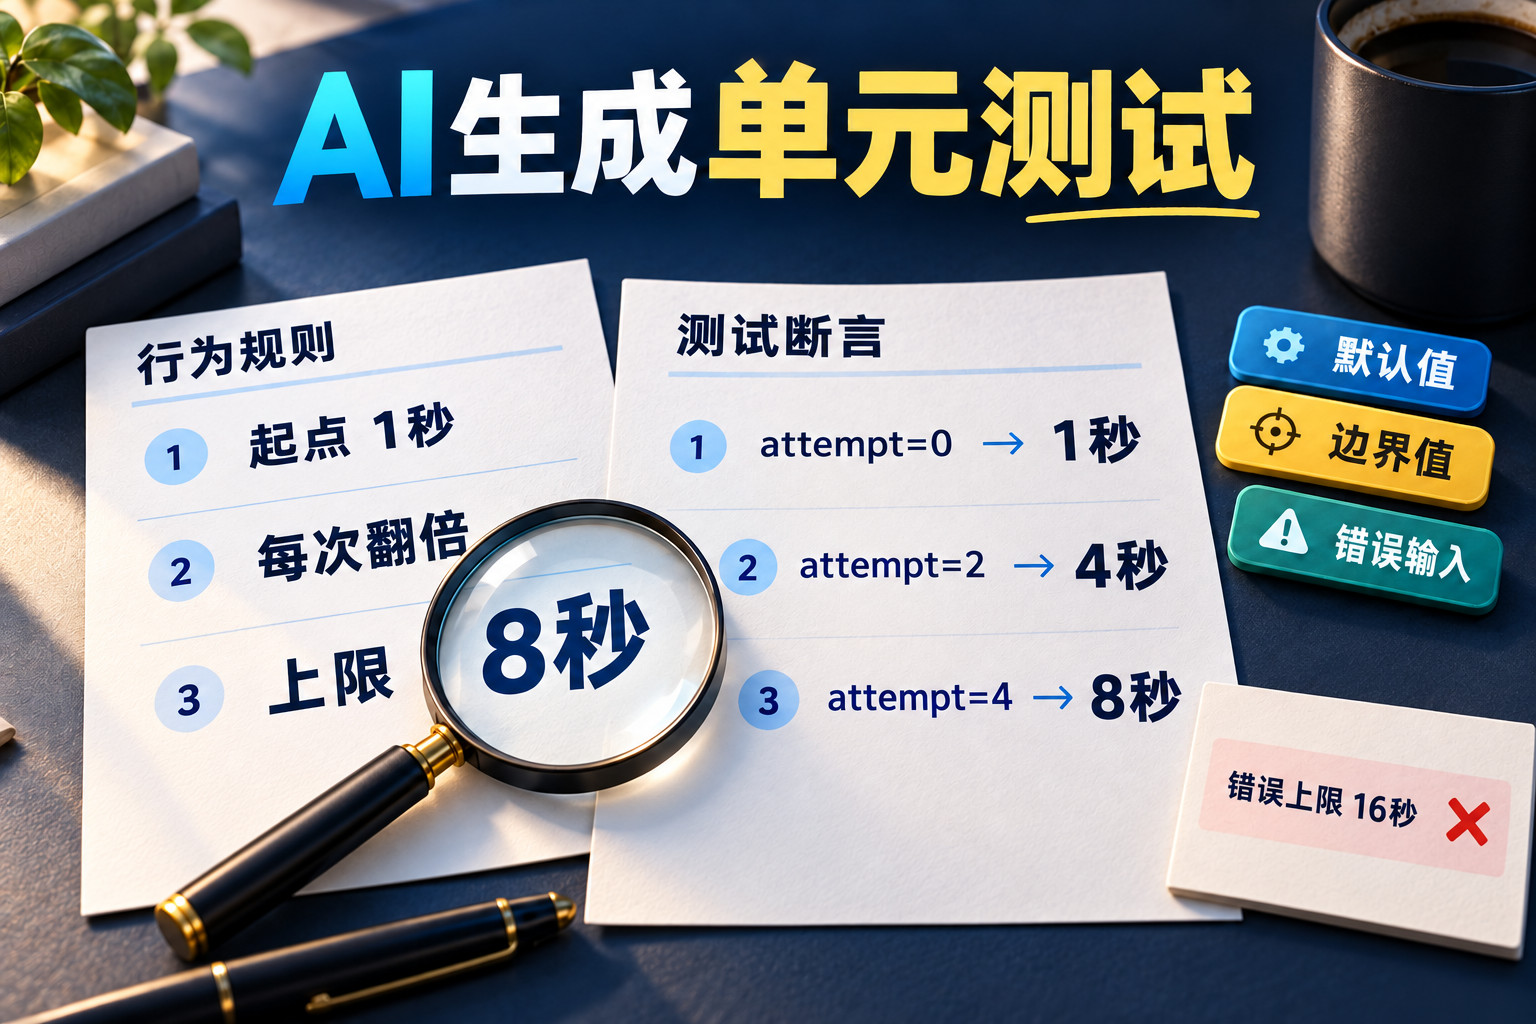
假设项目有一个计算重试等待时间的函数:第一次重试等1秒,此后按2倍增长,达到8秒后不再增加。参数attempt从0开始计数。这个小函数没有数据库和网络依赖,很适合观察AI生成的测试是否真正理解规则。
| 输入 | 预期结果 | 这条规则防什么问题 |
|---|---|---|
| 0、1、2 | 分别为1、2、4秒 | 起点错误、增长规律错误 |
| 3、4、100 | 都为8秒 | 上限只在某一次生效,后续又继续增长 |
| -1 | 抛出ValueError | 负数被当成有效重试次数 |
| 1.5、"1"、True | 抛出TypeError | 小数、文本或布尔值混进次数参数 |
这里明确排除布尔值,是本例的接口约定,并不是所有项目都要采用的默认规则。Python中布尔值与整数存在类型关系,如果没有提前讨论,AI可能接受True,也可能主动拒绝;两种实现都可能看似合理。测试前必须先把这种分歧交给维护者确认。
规则来源可以是需求、公开接口约定、历史缺陷或使用方的真实依赖。如果已有代码与规则冲突,先记录差异,不能让AI擅自把预期结果改成代码当前返回的值。
给AI最小但足够的项目上下文
给一个函数截图通常不够。AI还需要知道模块路径、项目测试框架、错误处理习惯,以及测试如何找到被测模块。优先提供目标文件、直接调用方、同目录已有测试和测试运行配置,不必把整个仓库无差别塞进任务。
可以把下面这段任务说明用于本地项目,把路径换成真实文件:
阅读retry.py、相邻测试和项目测试配置。先列出retry_delay的输入、返回值、异常以及代码与需求不一致的地方,等待规则确认。然后只新增或修改对应测试,沿用项目已有框架,不新增依赖,不修改生产代码。测试覆盖起点、增长、上限和非法输入。预期值直接来自我提供的规则表,不在测试里复制实现公式。最后给出实际运行命令、运行结果和仍未覆盖的行为;未运行时明确说明未运行。
GitHub的AI辅助测试指南也强调提供项目上下文、利用现有测试并检查生成结果。这些方法适用于评审AI产物;具体文件访问、命令执行和权限仍取决于当前工具与本机环境。
一个可以直接运行的小项目
新建空文件夹,放入下面两个文件。它们只使用Python标准库,目的是把“规则—断言—执行”走通。真实项目已有pytest、Jest或其他框架时,应按项目习惯补测试,不必改成unittest。
retry.py:被测函数
def retry_delay(attempt):
    if type(attempt) is not int:
        raise TypeError("attempt must be an integer")
    if attempt < 0:
        raise ValueError("attempt must be non-negative")
    if attempt >= 3:
        return 8
    return 2 ** attempt
test_retry.py:行为测试
import unittest
from retry import retry_delay


class RetryDelayTests(unittest.TestCase):
    def test_growth(self):
        for attempt, expected in [(0, 1), (1, 2), (2, 4)]:
            with self.subTest(attempt=attempt):
                self.assertEqual(retry_delay(attempt), expected)

    def test_cap(self):
        for attempt in [3, 4, 100]:
            with self.subTest(attempt=attempt):
                self.assertEqual(retry_delay(attempt), 8)

    def test_negative_attempt(self):
        with self.assertRaises(ValueError):
            retry_delay(-1)

    def test_invalid_types(self):
        for value in [1.5, "1", True]:
            with self.subTest(value=value):
                with self.assertRaises(TypeError):
                    retry_delay(value)


if __name__ == "__main__":
    unittest.main()
在这两个文件所在目录执行:
python -m unittest -v test_retry应看到4个测试方法通过。每个方法内部的多个输入通过subTest分别报告上下文,不能把“4个方法”误读成只检查了4种输入。Python unittest文档提供了断言、异常检查和命令行运行方式;本文使用其中的基础能力。
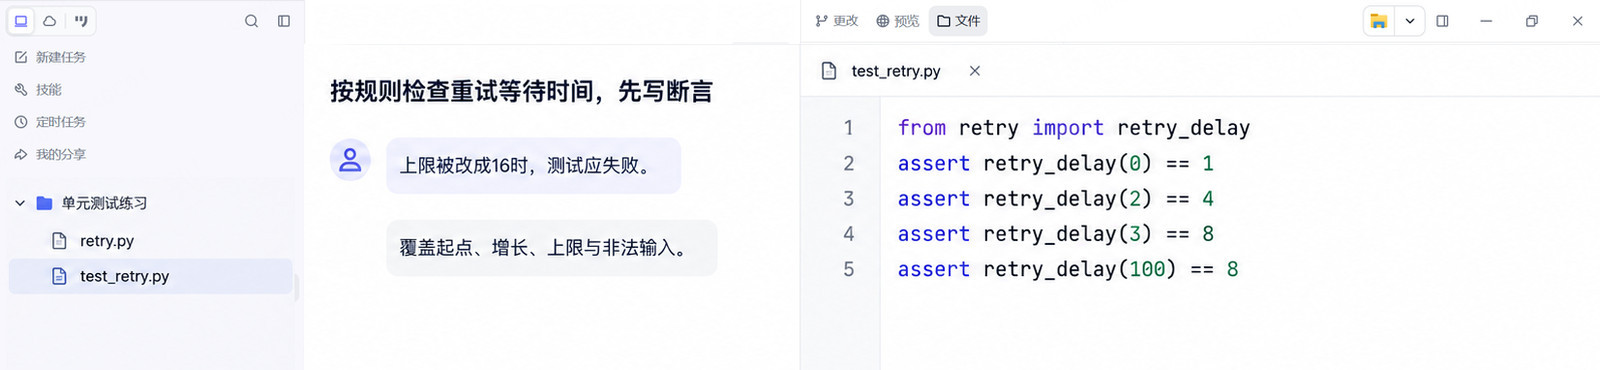
有意破坏一个规则,看测试能否发现
在练习副本中,把retry.py里的return 8临时改成return 16,再次运行同一命令。上限测试应失败,并报告期望8、实际16。随后恢复原代码,再运行,应重新通过。这个动作验证的是测试能否识别“上限被改坏”这一类回归,不代表所有问题都能被发现。
如果改坏后测试仍然通过,首先检查它是否真的调用了当前模块。其次检查断言是否只写“返回值不为空”,或者把函数也替换成了永远返回正确值的mock。还要看预期值是不是通过同一套错误公式算出来的:实现和测试共享错误假设,是AI补测试中很隐蔽的一类问题。
不要在正式工作分支里随意破坏业务代码。可以在独立练习目录、临时分支或隔离工作副本中完成这个验证,保留失败与恢复后的结果,评审时比单独一张绿色通过截图更有说明力。
什么时候需要mock,什么时候不需要
这个函数只计算数值,既不等待也不联网,因此无需mock。若测试的是真正发起重试的服务,则应区分“计算等待时间”和“执行网络请求”:单元测试可以替代网络、时钟等外部依赖,验证调用条件和错误处理,但不能把主要业务逻辑全部替换掉。
例如要验证失败后是否按约定重试,测试应控制外部请求的返回序列,并观察调用次数;如果把重试函数本身mock成成功,再断言成功,就没有验证重试行为。真实数据库事务、跨服务协议和页面交互还需要对应层级的测试,不能由这个函数的测试通过来代替。
若代码的核心行为来自数据库查询,就要继续核对查询口径。可以参考用小样本验证AI生成SQL的计数结果,通过重复记录和零记录对象检查查询,而不是只把数据库返回值mock成期望数字。该验证与纯函数单元测试属于不同范围,报告中应分别说明。
生成后,优先审查这三处
先看预期结果来源。测试名称写得漂亮不等于规则清楚。要求每个重要断言能够对应到需求、接口约定或已确认缺陷;对无法确认的行为留问题,不替团队做业务决定。
再看失败是否有信息。一大段准备代码最后只有一个“结果为真”,失败时往往无法定位。按一个行为组织测试,保留输入上下文,让报告能说明哪个边界出了问题。也不要把所有实现细节都锁死,否则合法重构会引发大量无意义失败。
最后看执行证据。命令、所在目录、依赖版本和结果必须对得上。测试未执行、因缺依赖中止、被跳过和真正通过是四种不同状态。AI写完文件后,继续追问“运行了哪个命令、失败在哪里、修改了什么”,比追加一句“再提高覆盖率”更有效。
如果目前还没有清晰的测试范围,可以先按AI生成测试用例的方法整理规则与风险,再挑稳定、边界明确的函数转成自动化测试。先让少量测试守住关键行为,再逐步扩展,比一次生成大量缺少依据的断言更容易维护。