AI生成SQL是否准确,不能只看查询有没有报错。更常见的错误是:同一个人被重复计算,没有记录的对象从报表中消失,或者“报名人数”和“有效报名人数”被当成同一个指标。生成前先写清数据对象、关联关系和统计口径,生成后用能手算的小样本核对,才有机会发现这些问题。
表结构、字段解释和查询草稿可以在墨刀AI客户端的本地项目中一起整理。把脱敏后的schema和口径文件提供给AI,让它先解释连接方案再写SQL;最终查询应在你有权限的测试环境中验证,不能因为客户端能读取文件,就假设它已经连接了企业数据库。
把“统计一下”写成可回答的问题
以培训课程为例,运营提出:“帮我统计每场课程的报名人数和到场人数。”先别急着生成SQL。这句话至少有四个未确定的条件:已取消报名算不算,重复扫码算几次,零报名课程是否保留,以及一个人报名两场课如何计算。
本例采用以下约定:以课程场次为一行,只统计状态为confirmed的有效报名;每条有效报名最多计一次到场,即使多次扫码;没有报名的场次也展示0;统计全部练习记录,不加日期筛选。并约定同一学员在同一场次只有一条报名记录。正式系统若不满足这个唯一性约定,需要先处理重复报名,不能直接照搬查询。
这段话就是取数口径。若后续增加月份、组织或渠道筛选,应写清用报名时间、课程时间还是签到时间,采用什么时区,开始与结束边界如何包含。不能把这些业务判断交给数据库函数默认处理。
先确认每张表的一行代表什么
| 表 | 一行的含义 | 关键字段 | 关系 |
|---|---|---|---|
| sessions | 一个课程场次 | id、name | 一场有多条报名 |
| registrations | 一名学员在一场的报名 | id、session_id、learner_id、status | 一条报名可能多次签到 |
| checkins | 一次扫码记录 | id、registration_id | 多次扫码可以指向同一报名 |
这里最危险的关系是报名与扫码的一对多。把三张表直接连接后,每条报名会随扫码次数重复出现。如果此时直接COUNT报名ID,“报名人数”也会被扫码次数放大。
因此,先把两项指标分别聚合到“场次”这一共同粒度,再连接到场次表。这个做法不是所有SQL都必须遵循的固定模板,但能让本例的计数来源和零值处理更容易审查。数据库对象与关联仍不熟悉时,可以先阅读产品经理理解数据库和业务对象的方法。
用四条报名构造能暴露错误的小样本
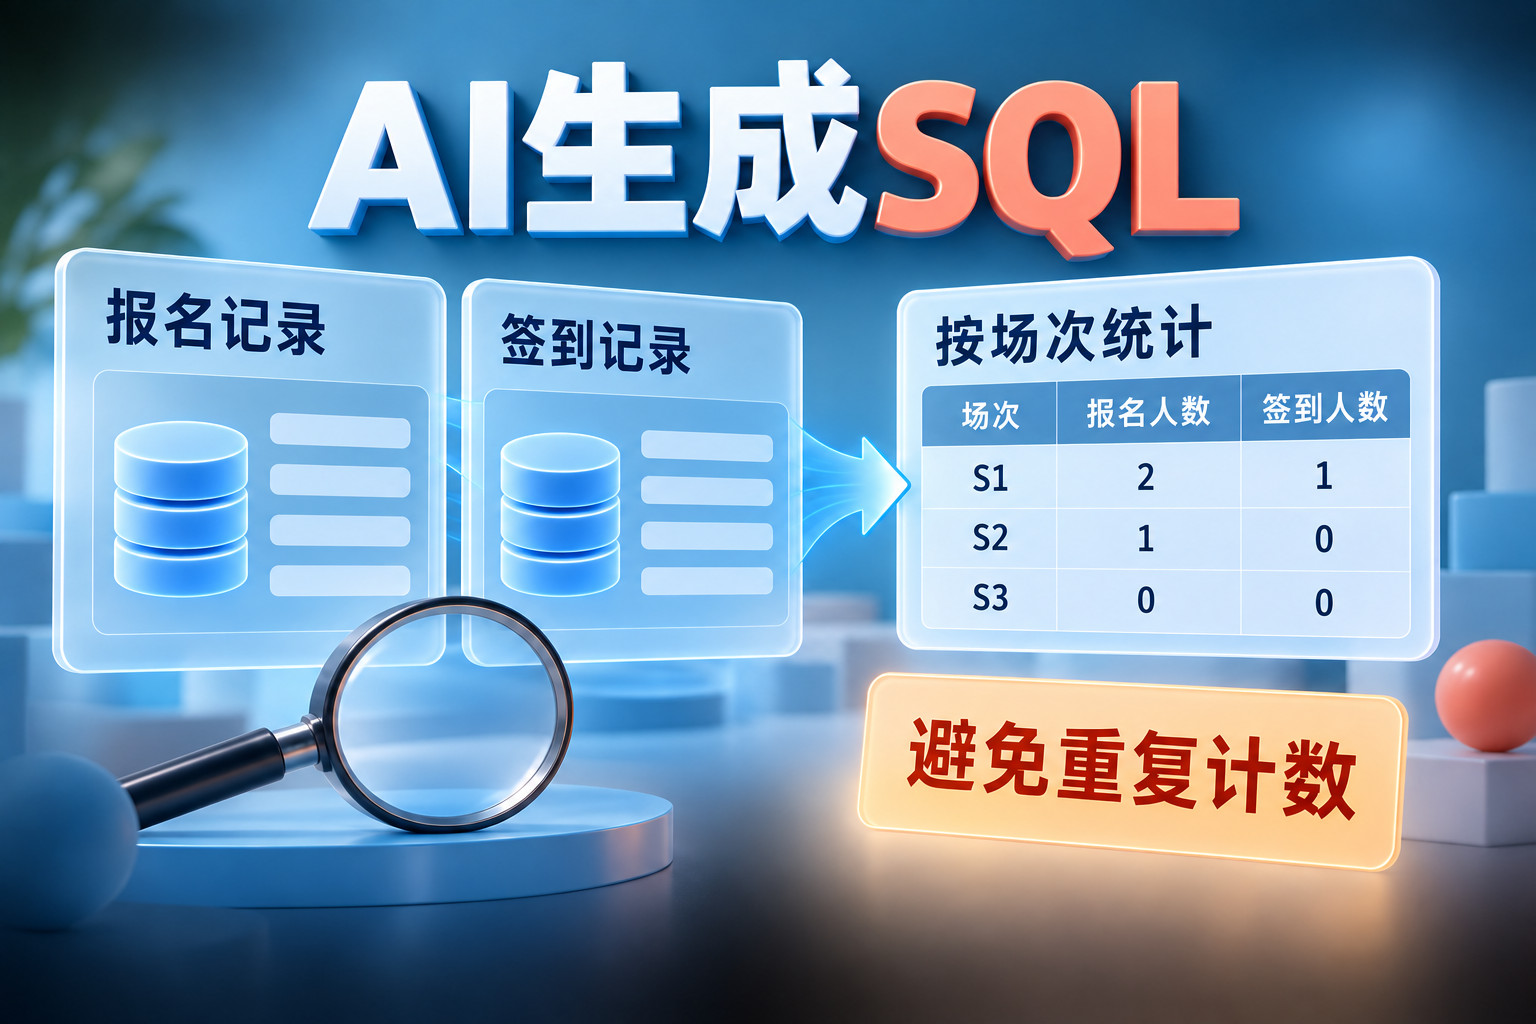
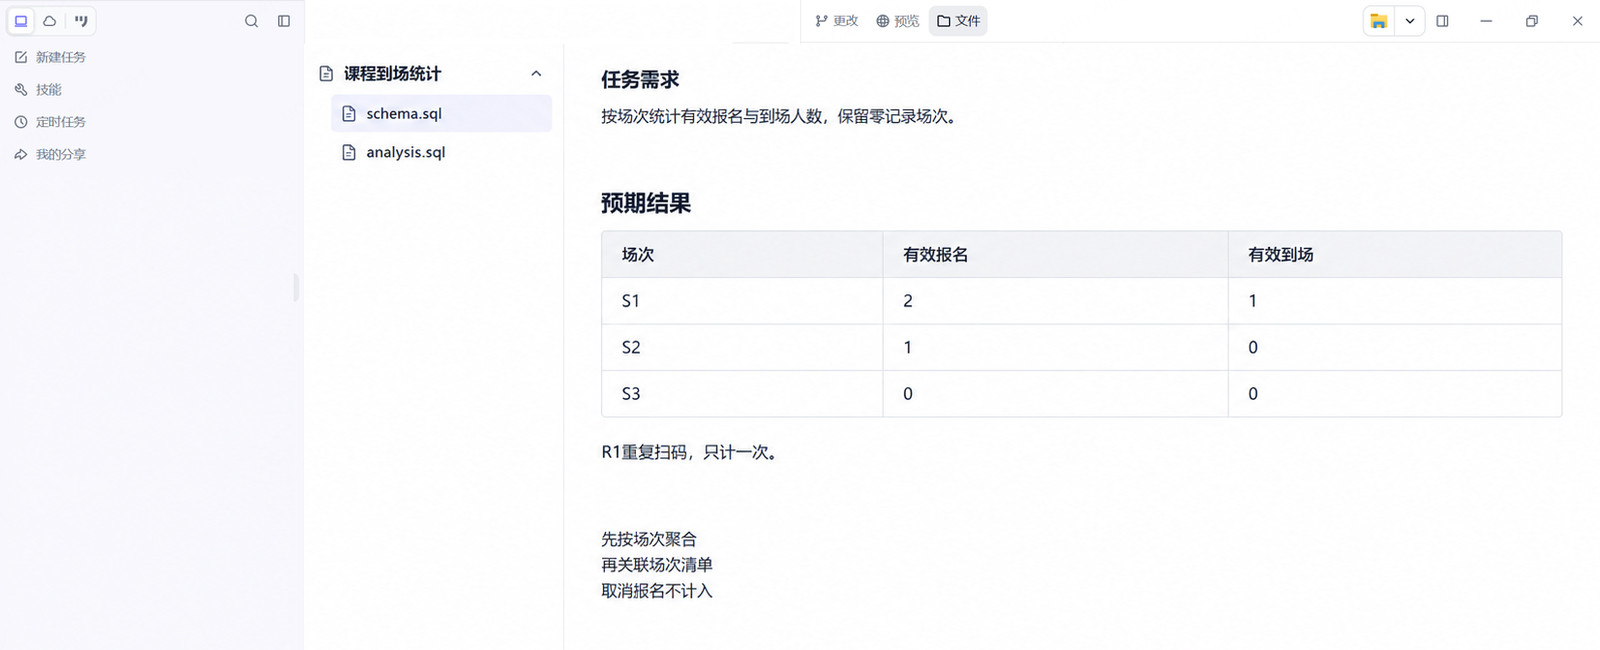
准备3个场次:S1、S2、S3。S1有R1、R2两条有效报名和R3一条取消报名;S2只有R4一条有效报名;S3没有报名。签到表中,R1有两次扫码,R3有一次扫码,其他报名没有扫码。它同时包含重复、取消和零记录三种容易漏掉的情况。
| 场次 | 有效报名 | 有效到场 | 计算理由 |
|---|---|---|---|
| S1 | 2 | 1 | R1和R2有效;R1虽扫两次只计一次;R3取消不计 |
| S2 | 1 | 0 | R4有效但未签到 |
| S3 | 0 | 0 | 仍保留该场次 |
这张预期结果表应先于SQL写好。只有正常记录的样本,无法区分一个“碰巧答对”的查询和真正符合口径的查询。小样本的价值在于暴露差异,而不是模拟大量真实业务数据。
让AI先解释计划,再输出查询
根据schema.sql和metrics.md,为SQLite写只读查询。输出每个场次的有效报名数和到场数,包含没有报名的场次。报名必须为confirmed;同一报名重复签到只算一次。先解释各表粒度、连接关系和去重对象,再生成SQL。不要猜不存在的字段,不要修改表,不要接入生产数据库。用给定小样本解释每一行结果;发现口径冲突时先列问题。
本例可以采用下面的查询,保存为analysis.sql:
WITH enrolled AS (
  SELECT session_id, COUNT(*) AS registrations
  FROM registrations
  WHERE status = 'confirmed'
  GROUP BY session_id
), attended AS (
  SELECT r.session_id,
         COUNT(DISTINCT c.registration_id) AS attendees
  FROM checkins AS c
  JOIN registrations AS r ON r.id = c.registration_id
  WHERE r.status = 'confirmed'
  GROUP BY r.session_id
)
SELECT s.id,
       COALESCE(e.registrations, 0) AS registrations,
       COALESCE(a.attendees, 0) AS attendees
FROM sessions AS s
LEFT JOIN enrolled AS e ON e.session_id = s.id
LEFT JOIN attended AS a ON a.session_id = s.id
ORDER BY s.id;
enrolled只数有效报名;attended按报名ID去重后计算有效到场;最后从sessions出发,用LEFT JOIN保留所有场次,用COALESCE把没有匹配到的计数显示为0。SQLite的SELECT文档可以用于核对连接、聚合与筛选语义。换用MySQL、PostgreSQL或数据仓库时,仍要核对实际字段、方言及执行计划。
在本地内存数据库里验证结果
将下面内容保存为verify_query.py,与analysis.sql放在同一目录。脚本使用Python标准库sqlite3创建内存数据库,退出后练习数据消失,不会连接外部数据库。
import sqlite3
from pathlib import Path

db = sqlite3.connect(":memory:")
db.executescript("""
CREATE TABLE sessions (id TEXT PRIMARY KEY, name TEXT);
CREATE TABLE registrations (
  id TEXT PRIMARY KEY, session_id TEXT,
  learner_id TEXT, status TEXT
);
CREATE TABLE checkins (id TEXT PRIMARY KEY, registration_id TEXT);
INSERT INTO sessions VALUES ('S1','原型入门'),('S2','需求评审'),('S3','界面基础');
INSERT INTO registrations VALUES
 ('R1','S1','U1','confirmed'),('R2','S1','U2','confirmed'),
 ('R3','S1','U3','cancelled'),('R4','S2','U1','confirmed');
INSERT INTO checkins VALUES ('C1','R1'),('C2','R1'),('C3','R3');
""")
query = Path(__file__).with_name("analysis.sql").read_text(encoding="utf-8")
rows = db.execute(query).fetchall()
expected = [('S1', 2, 1), ('S2', 1, 0), ('S3', 0, 0)]
if rows != expected:
    raise AssertionError(f"Expected {expected}, got {rows}")
for row in rows:
    print(*row)
db.close()运行python verify_query.py,预期输出S1 2 1、S2 1 0、S3 0 0。这里验证了给定数据与口径的一致性,没有验证真实系统中所有异常数据,也没有评价大表查询性能。
这类小样本验证适合随着查询保存在项目里。若还需要为结果转换、参数校验等纯函数补自动测试,可以使用AI生成单元测试的规则与断言方法;查询集成验证与函数测试分别运行,才能看清是哪一层行为发生了变化。
SQL能运行,却答错的三种情况
连接后直接计数。把报名和扫码明细连接再COUNT(*),R1会出现两次。改成COUNT(DISTINCT ...)之前也要确认应该按报名、用户还是事件去重;随手加DISTINCT可能隐藏数据问题。
把右表条件写在最终WHERE里。如果LEFT JOIN之后在WHERE要求右表status等于confirmed,没有匹配记录的场次可能被过滤掉。把条件放在合适的子查询或连接条件里,并用S3这样的零记录场次验证。
把取消报名的扫码也计入到场。“有签到”并不自动等于本次统计的有效到场。是否纳入取消后到场、补报名等情况,必须由业务定义。本例按当前报名状态过滤;若要还原签到当时的状态,还需要历史状态或事件数据,当前这份表结构无法回答。
从练习迁移到真实项目
先把指标定义与查询放在一起保存,注明使用的表、状态口径、时间范围和结果粒度。接着让数据负责人核对字段,再在只读、有限数据范围内验证;结果正确后才讨论索引、扫描量和运行计划。查询很快不说明统计正确,统计正确也不说明大规模运行成本合理。
如果统计口径和结果已经核对、查询仍然很慢,再按慢SQL执行计划分析方法检查扫描与排序,并在调整索引后验证结果没有变化。
交付给同事时,附上一个正常样本、一个重复样本和一个零记录样本,让接手的人能迅速复核核心逻辑。如果业务要的是“找到报名后未到场的人继续跟进”,则还需要另写明细查询,不能把汇总数当作人员名单。AI最有用的地方,是帮助保持口径、SQL和验证材料同步,而不是替团队猜一个数字出来。