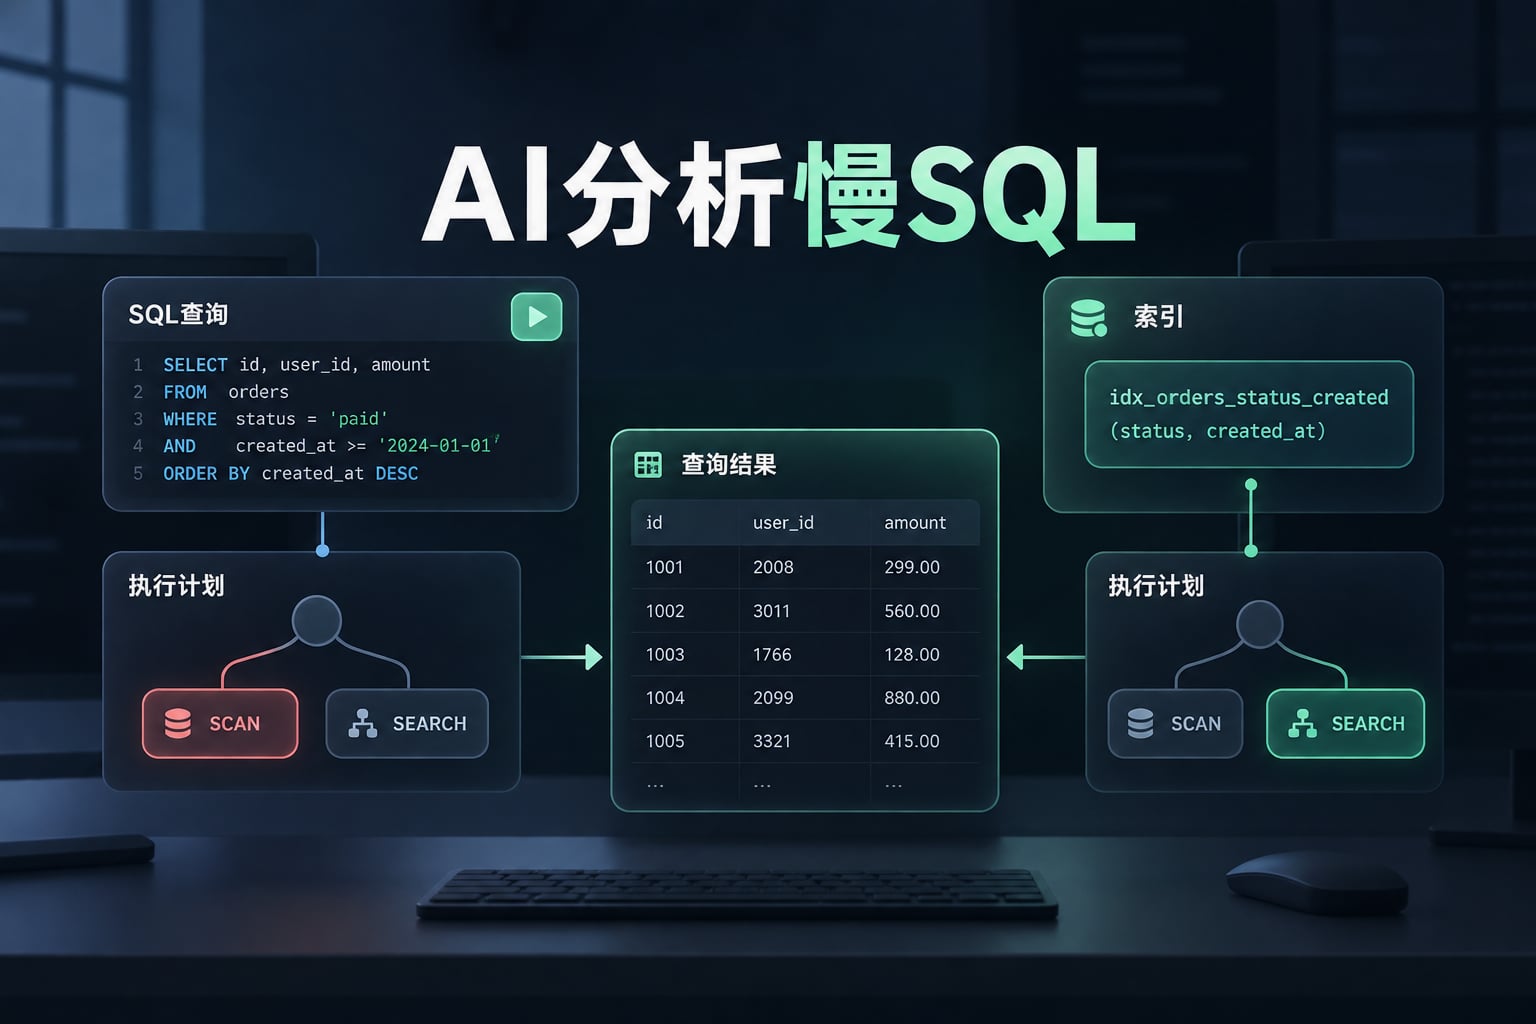
AI分析慢SQL,应从实际查询、参数、表结构、索引和执行计划开始,再提出能验证的修改。先检查结果是否正确,再区分扫描、排序、连接或数据估计的问题;不能只看到“全表扫描”就断言必须加索引,更不能凭改写后的SQL外观宣称提速。
把查询文件、结构说明和计划输出保存在本地项目中,可以用墨刀AI客户端整理查询依据与优化假设。先要求解释计划中的具体节点,再决定需要补充什么证据。本例使用独立的SQLite内存数据,不接触线上数据库。
提供查询上下文,比一句“帮我优化”更有用
同一条查询在十几行和几千万行数据上,合理的计划可能不同。参数分布、索引选择、排序要求和返回行数也会改变成本。输入材料至少包含数据库与版本、完整SQL、脱敏参数、表及索引定义、计划输出,以及用户感到慢的具体操作。
如果查询连统计口径都未确定,先按AI生成SQL的口径与结果校验方法确认含义。优化一个漏掉租户条件或重复计算订单的查询,即使执行更快,也不是正确结果。
计划中的估计成本不是所有数据库通用的毫秒数。不同引擎的命令和字段要分别解释,不能把PostgreSQL的输出直接套到SQLite或MySQL。还需区分只展示计划与实际执行并收集统计的命令;实际执行可能产生负载或业务影响,应按环境权限选择。
运行一个结果可对照的SQLite小例
工单列表要找某团队处于open状态的最近20条记录,按创建时间和编号降序排列。下面程序建立6000条本地数据,打印索引前后计划,并检查四组参数的结果没有变化。保存为slow-sql.py,用python slow-sql.py运行。
import sqlite3

db = sqlite3.connect(":memory:")
db.execute("CREATE TABLE tickets (id INTEGER PRIMARY KEY, team_id INTEGER, status TEXT, created_at INTEGER)")
db.executemany("INSERT INTO tickets VALUES (?, ?, ?, ?)", [
    (i, i % 20, "closed" if i % 3 == 0 else "open", i)
    for i in range(1, 6001)
])
sql = """SELECT id, status FROM tickets
WHERE team_id = ? AND status = ?
ORDER BY created_at DESC, id DESC LIMIT 20"""
params = (7, "open")
cases = [(7, "open"), (7, "closed"), (19, "open"), (99, "open")]
before = {p: db.execute(sql, p).fetchall() for p in cases}
print("SQLite:", sqlite3.sqlite_version)
print("before:", db.execute("EXPLAIN QUERY PLAN " + sql, params).fetchall())
db.execute("CREATE INDEX idx_tickets_list ON tickets(team_id, status, created_at DESC, id DESC)")
print("after:", db.execute("EXPLAIN QUERY PLAN " + sql, params).fetchall())
for p in cases:
    assert before[p] == db.execute(sql, p).fetchall(), p
print("result_equal: 4/4; main_rows:", len(before[params]))
# 删掉团队条件会改变含义,不能当成优化。
wrong = db.execute("SELECT id, status FROM tickets WHERE status = ? ORDER BY created_at DESC, id DESC LIMIT 20", ("open",)).fetchall()
assert wrong != before[params]
print("missing_team_filter: rejected")
db.close()
本次在Python 3.12.14、SQLite 3.53.1验证:增加索引前出现SCAN tickets及临时排序;增加索引后出现使用idx_tickets_list的搜索计划。四组参数结果一致,主查询返回20行;删除团队条件的错误改法被识别为结果不同。
程序没有记录生产耗时,也没有证明真实项目可以提升某个百分比。它验证的是一个更小但有用的事实:本例的索引改变了访问和排序方式,同时保留了检查范围内的查询结果。
让AI解释计划,而不是只输出一条索引语句
SQLite的执行计划说明解释了SCAN、SEARCH和临时排序等信息,并说明调试输出格式可能随版本变化。读计划时应关注访问策略,别把具体节点编号当成长期稳定的接口。
本例的候选索引先放等值筛选字段team_id、status,再覆盖排序字段created_at、id。请AI说明每个字段为什么在这个位置、服务于哪条条件,以及少一个排序字段可能带来什么变化。若它只能说“复合索引更快”,理由还不充分。
读取slow-sql.py和前后执行计划。先解释筛选与排序如何被执行,再列出本例索引影响的节点。不要给出没有计时依据的提速数字。分别检查团队条件、状态条件、排序和返回上限是否保留,并指出该索引对写入及其他查询可能有什么代价。
索引也有维护与存储成本。工单频繁变更状态时,相关索引需要维护;给每个筛选组合都建立一条索引,可能换来另一个问题。优化判断要回到实际读写负载,不能把本例的索引复制到名字相近的表上。
候选方案一次只改清楚的一件事
把加索引、改分页、删字段、调整连接全部混在一起,即使结果变快,也难以判断原因。可以建立一个小记录:原问题、候选修改、预期变化、实际计划、结果一致性和未覆盖条件。每次对照使用同一组数据和参数。
| 候选 | 需要证明什么 | 不能忽略什么 |
|---|---|---|
| 增加索引 | 目标查询采用何种访问策略 | 写入成本与现有索引重叠 |
| 减少返回字段 | 调用方不再需要被移除的字段 | 隐含依赖与导出用途 |
| 改写连接或子查询 | 重复行、空值和聚合结果一致 | 只对比总行数可能漏掉内容差异 |
| 改变分页方式 | 连续翻页不漏不重 | 排序稳定性与已有API约定 |
从本地例子走向真实项目
迁移到实际数据库时,先换成对应引擎的计划与数据统计,选有代表性的参数,包括结果为空、结果较多和边界范围。比较方案时说明缓存与并发条件;仅重复运行一次变快,可能只是数据已经进入缓存。
最终留下可复现的查询、参数、修改说明和验证记录。AI可以帮助把这些材料串起来,但“优化完成”的依据应是结果正确、目标负载下表现改善且代价可接受,而不是得到一条看起来专业的SQL。