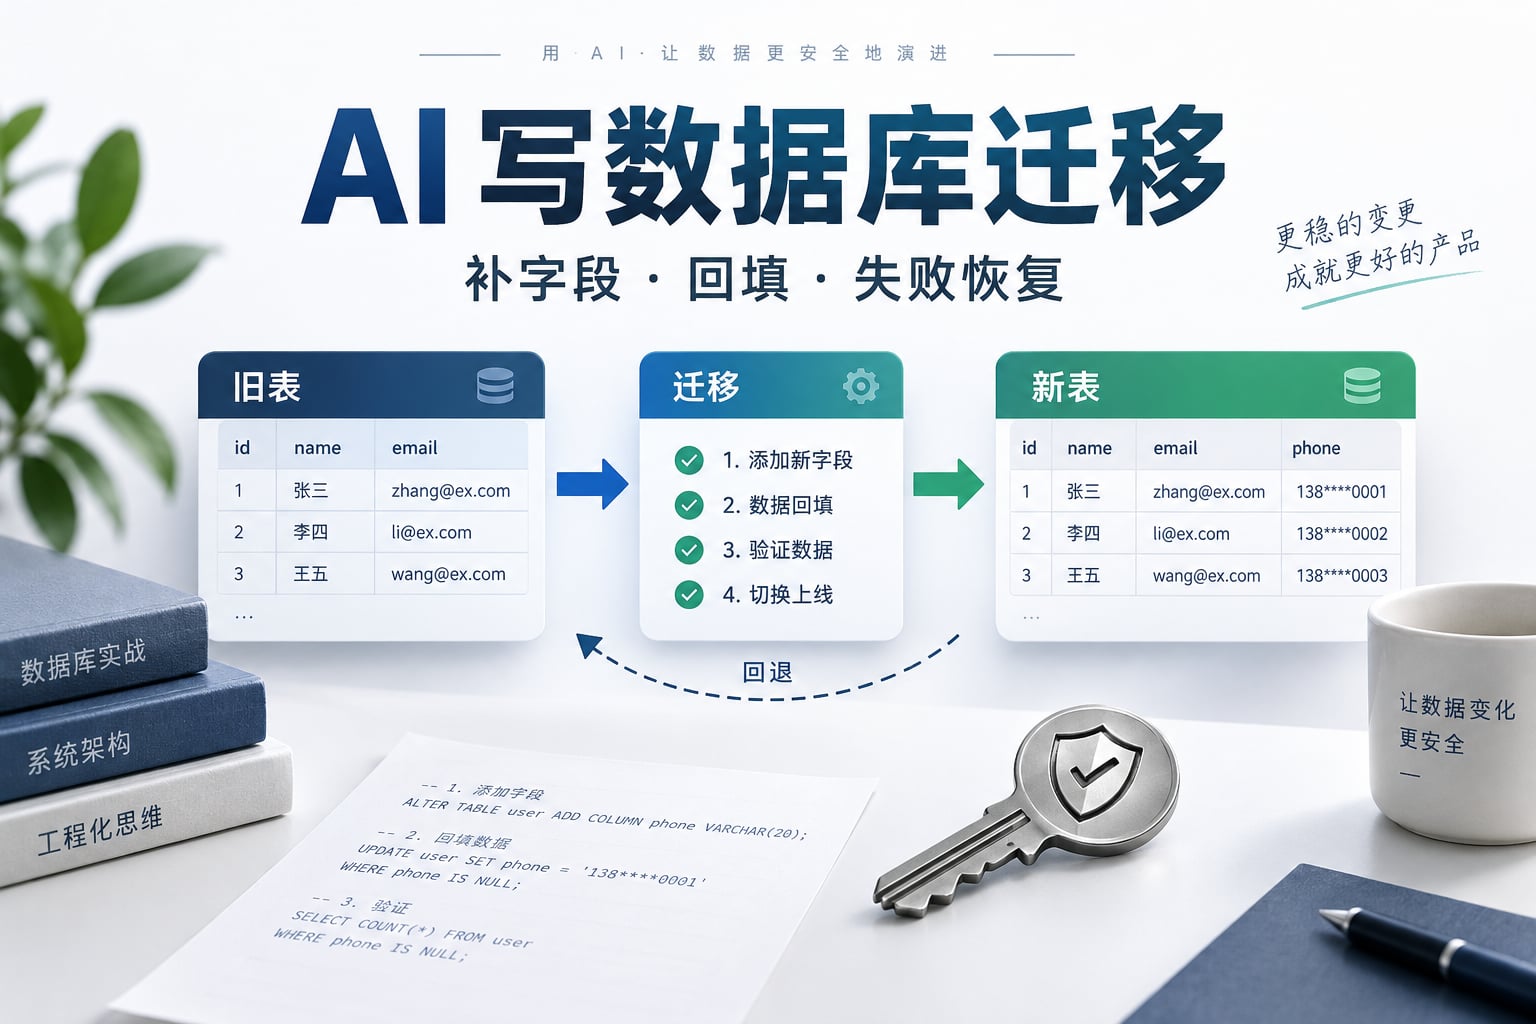
让AI写数据库迁移,首先要写清旧数据怎样变成新数据,而不只是描述新增字段。可执行的交付应同时包含结构变化、回填规则、执行前检查、执行后核对,以及中途失败时恢复到什么状态。语法正确,只能说明迁移有机会运行,不能证明原有记录没有被改坏。
下面把工单表中的紧急标记转换成优先级字段。可以把现有表结构和转换规则交给墨刀AI客户端整理迁移步骤与检查脚本,再在项目实际使用的数据库环境中验证。本篇提供一份可复制的Python脚本,验证记录来自本地SQLite执行。
把“新增优先级”写成明确的数据规则
原表tickets已有id、title和urgent,urgent通常为0或1。新版本需要priority,取值只能是normal或high。此次先增加新字段并保留urgent,让后续应用改造有过渡空间。
| 旧数据或执行条件 | 本次处理 | 检查目标 |
|---|---|---|
| urgent = 0 | priority = normal | 所有对应行值一致 |
| urgent = 1 | priority = high | 没有漏掉紧急工单 |
| urgent为NULL或其他值 | 停止,先确认业务含义 | 不把异常旧值静默归为normal |
| 原有id、title、urgent | 全部保留 | 迁移前后逐行比较 |
| 结构版本不是1 | 拒绝执行 | 避免重复加列或错序迁移 |
这些规则比“写一段安全的SQL”更有约束力。尤其是NULL:它可能表示未知、未同步或历史缺失,不能由AI自行解释成“不紧急”。真实数据中的异常应先按编号汇总,交由了解业务的人确定修复方式。
给AI的任务可以直接写成:“基于下面的SQLite表结构,将urgent为0和1的记录分别回填为normal和high。其他旧值必须报错,不得修改原字段。提供一个事务内的迁移函数、版本检查、失败后原结构仍在的断言,以及包含异常值的验证数据。”同时附上数据库类型和版本,不能只发一张字段截图。
先理解这份脚本改变什么
脚本只使用Python标准库,数据库放在内存中。正常数据是三张工单,紧急标记依次为0、1、0。迁移前读取原字段,新增带默认值和CHECK约束的priority,再把紧急记录回填为high,最后比对原字段和新字段。
SQLite的ALTER TABLE文档说明了新增列等操作的支持范围和限制。本例用到的是ADD COLUMN,没有演示删除旧列、重建表、外键、索引或触发器迁移。其他数据库对DDL和事务的处理可能不同,不能把下面的恢复结论直接套到MySQL或PostgreSQL。
将下面内容保存为migration_demo.py,用普通方式执行python migration_demo.py。断言是检查的一部分,不要使用会移除断言的Python优化选项。
import json
import sqlite3


def database(urgent_values):
    db = sqlite3.connect(':memory:', isolation_level=None)
    db.execute('CREATE TABLE tickets(id INTEGER PRIMARY KEY, title TEXT, urgent INTEGER)')
    db.executemany('INSERT INTO tickets VALUES(?, ?, ?)',
                   [(i, f'ticket-{i}', v) for i, v in enumerate(urgent_values, 1)])
    db.execute('PRAGMA user_version=1')
    return db


def migrate(db, inject_failure=False):
    if db.execute('PRAGMA user_version').fetchone()[0] != 1:
        raise ValueError('expected schema version 1')
    db.execute('BEGIN IMMEDIATE')
    try:
        before = db.execute('SELECT id,title,urgent FROM tickets ORDER BY id').fetchall()
        if any(row[2] not in (0, 1) for row in before):
            raise ValueError('urgent must be 0 or 1; resolve legacy rows first')
        db.execute("ALTER TABLE tickets ADD COLUMN priority TEXT NOT NULL "
                   "DEFAULT 'normal' CHECK(priority IN ('normal','high'))")
        db.execute("UPDATE tickets SET priority='high' WHERE urgent=1")
        if inject_failure:
            db.execute("UPDATE tickets SET priority='rush' WHERE id=1")
        after = db.execute('SELECT id,title,urgent FROM tickets ORDER BY id').fetchall()
        if after != before:
            raise RuntimeError('original rows changed')
        expected = [(row[0], 'high' if row[2] == 1 else 'normal') for row in before]
        actual = db.execute('SELECT id,priority FROM tickets ORDER BY id').fetchall()
        if actual != expected:
            raise RuntimeError('backfill mismatch')
        db.execute('PRAGMA user_version=2')
        db.execute('COMMIT')
        return actual
    except Exception:
        if db.in_transaction:
            db.execute('ROLLBACK')
        raise


report = {'sqlite_version': sqlite3.sqlite_version, 'checks': []}
db = database([0, 1, 0])
assert migrate(db) == [(1, 'normal'), (2, 'high'), (3, 'normal')]
assert db.execute('PRAGMA user_version').fetchone()[0] == 2
report['checks'].append('valid_backfill_preserves_three_rows')
try:
    migrate(db)
except ValueError:
    report['checks'].append('second_run_rejected_by_version')
else:
    raise AssertionError('second run unexpectedly accepted')
db.close()

for values, inject, error, label in [
    ([0, 2], False, ValueError, 'invalid_legacy_value'),
    ([0, None], False, ValueError, 'null_legacy_value'),
    ([0, 1], True, sqlite3.IntegrityError, 'constraint_failure'),
]:
    db = database(values)
    old = db.execute('SELECT * FROM tickets ORDER BY id').fetchall()
    try:
        migrate(db, inject)
    except error:
        assert db.execute('SELECT * FROM tickets ORDER BY id').fetchall() == old
        assert 'priority' not in [r[1] for r in db.execute('PRAGMA table_info(tickets)')]
        assert db.execute('PRAGMA user_version').fetchone()[0] == 1
        report['checks'].append(label + '_keeps_original_schema_and_rows')
    else:
        raise AssertionError(label + ' was not rejected')
    db.close()
print(json.dumps(report, ensure_ascii=False, indent=2))
成功路径之外,故意让它在中间失败
本地执行使用SQLite 3.53.1。正常场景迁移前后都是3行,原有三个字段逐行一致;新字段得到normal、high、normal。版本号从1变为2,再执行同一迁移会被版本检查拒绝,而不是尝试再加一次列。
| 运行场景 | 观察结果 | 验证意义 |
|---|---|---|
| 旧值0、1、0 | 正常提交,映射全部匹配 | 回填规则与原记录保留同时成立 |
| 旧值包含2 | 拒绝,原结构与记录保留 | 未知旧状态没有被默认值掩盖 |
| 旧值包含NULL | 拒绝,原结构与记录保留 | 缺失值需要独立处理 |
| 加列后强行写入rush | 约束失败,回滚后priority列不存在 | 失败发生在结构已改变之后,仍能恢复本例事务 |
| 迁移成功后再运行 | 拒绝,提示版本不匹配 | 防止错把同一迁移执行两次 |
异常分支显式执行ROLLBACK,是因为遇到错误不等于整个事务一定已经撤销。SQLite事务文档区分了语句与事务的失败行为。验证时不仅要看到报错,还要重新读取表结构、旧记录和版本号,确认它们确实回到了预期状态。
事务回滚与上线后撤回,是两件不同的事
这份脚本证明的是提交前失败可恢复。提交成功以后,新应用可能已经写入priority;此时再把新列删掉会丢失新增信息,并不是前面ROLLBACK的延伸。因此,回退方案要说明应用回到哪个版本、哪些字段仍可读写、迁移后的新增数据如何保留。
保留urgent也不代表新旧版本天然兼容。旧应用如果继续插入urgent = 1而不填写priority,新字段默认值仍会是normal,形成矛盾。在允许新旧应用同时运行的发布方案中,需要明确写入责任,例如先让应用同步维护两列,再回填并核对,最后切换读取;具体顺序取决于部署方式。本例没有验证在线并发写入。
真实项目还应在库副本上核对表大小、相关索引、外键、触发器和依赖查询,评估锁等待与执行时长。脚本使用BEGIN IMMEDIATE,并不意味着大型数据库迁移不会阻塞业务;SQLite同一时间只有一个写事务。
交给评审者一份能复核的迁移包
提交时把变更脚本与检查结果放在一起:原结构和目标结构、每种旧值的行数、异常记录编号、版本前提、正常与失败日志,以及提交后的应用兼容方案。AI修改脚本后,应重新运行这些检查,不能沿用上一个版本的通过记录。
如果任务只是查询统计数据,可先看AI生成SQL的口径与结果校验;准备更多关联和边界数据时,可参考可复现测试数据的组织方法。数据库迁移最终交付的不是一段看起来正确的DDL,而是一组能说明旧数据去向、失败状态和部署约束的证据。