用AI生成测试数据,先让它读字段和业务规则,再生成数据与校验文件。只有姓名、标题看起来像真的还不够:主键要唯一,关联字段要能找到对象,状态与日期不能互相矛盾,边界值也要有明确用途。
更稳妥的做法是把数据分为正常、边界和故意错误三组,并保存生成规则、固定种子、参考日期与版本。需要整理本地接口定义、字段文档和样例时,可以用墨刀AI客户端辅助建立生成脚本和检查文件,让同一批数据服务于原型展示、前端联调与测试。
测试数据和测试用例,解决的是两件事
“输入过长标题,点击提交,预期出现长度提示”是一条测试用例;那段超过长度限制的标题,才是它需要的数据。如果AI只输出几十条格式相似的记录,数量虽然多,却可能没有覆盖任何新条件。
因此,准备数据前先问:这批数据要支撑哪个动作?展示空列表、验证超长文本、核对筛选结果,还是检查部门与工单关联?把目标写在数据清单里,才能知道每一组记录为什么存在。完整执行步骤可另外整理成测试用例,不必让数据文件同时承担操作说明。
先为售后工单写一份字段规则
下面用一组自建售后工单说明方法。部门包含售后组和技术组,工单可处于待处理、处理中、已关闭三种状态。业务规则中,已关闭工单必须有关闭时间,未关闭工单的关闭时间为空;标题长度为1到80个字符。实际项目应替换为自己的接口和存储约定。
| 字段 | 约束 | 要准备的代表值 |
|---|---|---|
| id | 非空、唯一 | 正常编号,另备重复编号作为错误集 |
| departmentId | 必须对应部门表中的id | 两个有效部门,另备不存在的部门 |
| title | 1—80个字符 | 1字符、普通标题、80字符、81字符 |
| status | open / in_progress / closed | 三种合法值,另备unknown |
| closedAt | 已关闭时非空,其它状态为空 | 有效时间、遗漏时间、与状态矛盾的时间 |
这些约束不应全靠AI猜。优先读取当前接口字段文档、类型定义、schema和真实校验代码。文档与实现不一致时,把冲突列出来,由负责人员确认哪个规则正确,再决定如何生成。
JSON Schema对象文档中,属性规则与必填声明是分开的:在properties里出现一个字段,并不自动意味着它必须存在。验证方案除了格式,还应覆盖必填、额外字段、唯一性和跨记录关系;后两项常常需要业务校验补充。
把正常、边界和错误数据分开存放
正常集用于演示和基本联调;边界集仍应符合业务规则,只是刚好落在允许范围边缘;错误集故意违反规则,用来确认系统能够拒绝。三者混在一起,开发者很容易把“预期失败”误认为生成器坏了,或者把错误数据导入演示页面。
例如,80字符标题属于边界集,81字符标题属于错误集;待处理工单的关闭时间为空符合本例规则,但引用一个不存在的部门属于关联错误。是否允许为空,要由字段规则决定,不能用“看起来不完整”代替判断。本例的字符数按Python的len统计Unicode码点;含emoji等内容时,应与前端、接口的计数方式统一,再确定长度边界。
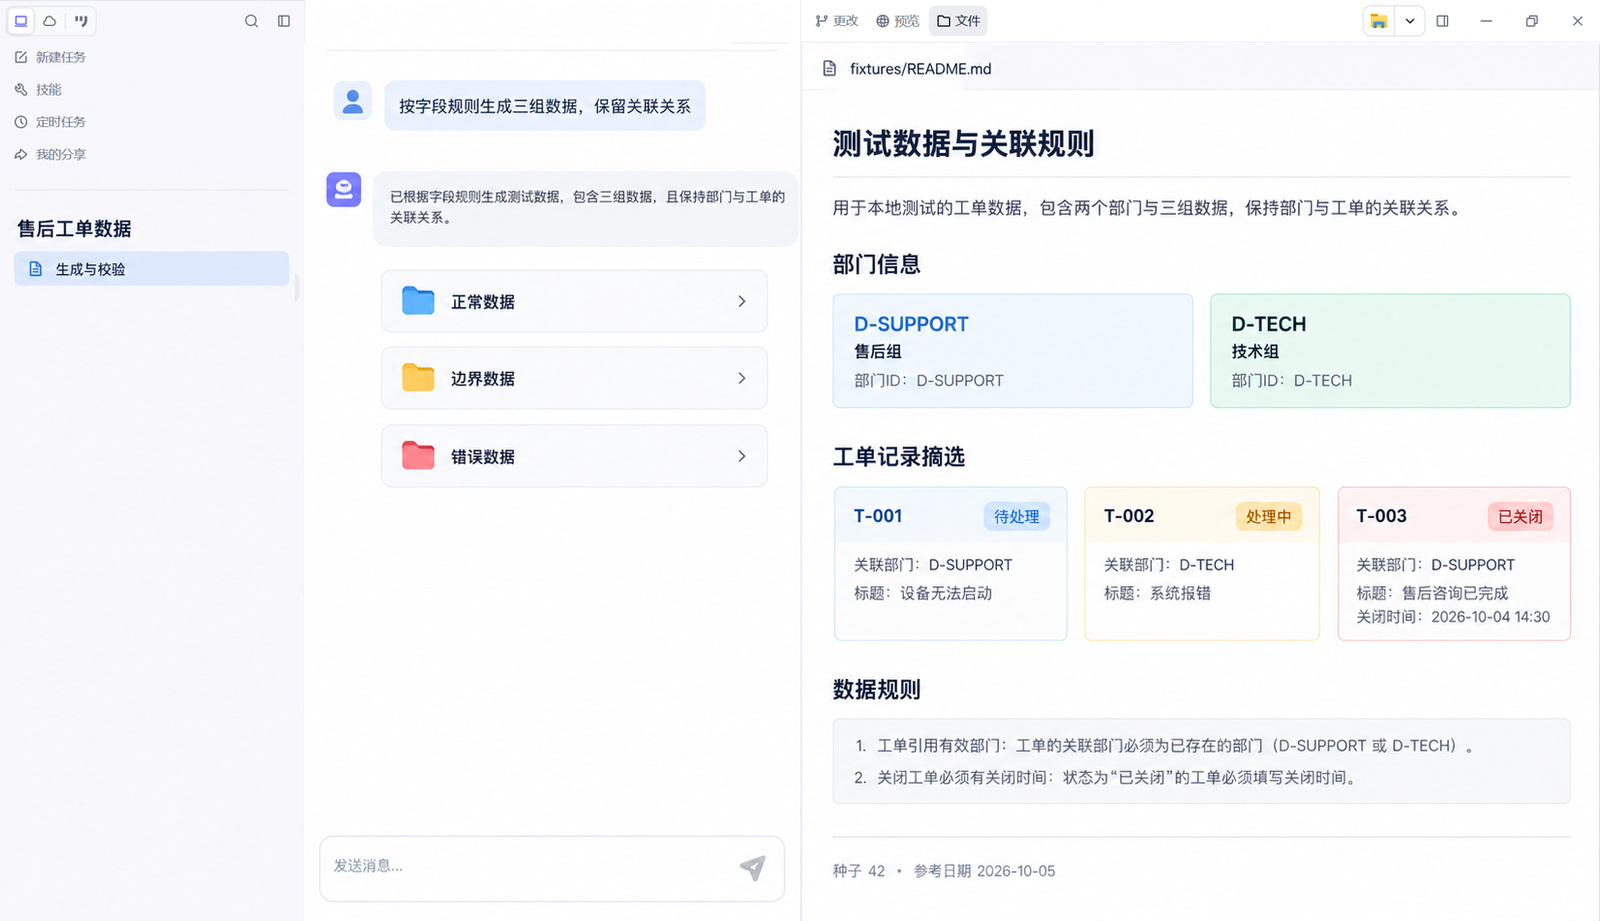
下面这份小样本可以直接用于核对字段关系。数据只用测试编号和业务描述,不需要真实姓名、电话或生产工单内容:
{
  "departments": [
    {"id": "D-SUPPORT", "name": "售后组"},
    {"id": "D-TECH", "name": "技术组"}
  ],
  "tickets": [
    {"id": "T-001", "departmentId": "D-SUPPORT",
     "title": "退款进度咨询", "status": "open", "closedAt": null},
    {"id": "T-002", "departmentId": "D-TECH",
     "title": "附件预览无法打开", "status": "in_progress", "closedAt": null},
    {"id": "T-003", "departmentId": "D-SUPPORT",
     "title": "地址修改已确认", "status": "closed",
     "closedAt": "2026-10-05T00:00:00Z"}
  ]
}
需要更多记录时,生成脚本比一大段JSON更好维护
少量固定记录适合评审,几十到几百条用于分页、排序或列表性能时,最好保存生成器。生成器应先创建父记录,再从已经存在的父id中选关联值。不能让AI分别生成两个表后,期待编号恰好对应。
下面的Python脚本使用固定种子与固定时间生成12条正常工单,并在写出前检查几项业务约束。保存为make_fixtures.py,在一个空的测试目录执行python make_fixtures.py,会得到可重复生成的JSON文件:
import json
import random
from pathlib import Path

rng = random.Random(42)
departments = [{"id": "D-SUPPORT", "name": "售后组"},
               {"id": "D-TECH", "name": "技术组"}]
department_ids = [d["id"] for d in departments]
statuses = ["open", "in_progress", "closed"]
reference_time = "2026-10-05T00:00:00Z"
tickets = []
for i in range(12):
    status = statuses[i % len(statuses)]
    tickets.append({
        "id": f"T-{i + 1:03d}",
        "departmentId": rng.choice(department_ids),
        "title": f"测试工单{i + 1}",
        "status": status,
        "closedAt": reference_time if status == "closed" else None
    })

assert len({t["id"] for t in tickets}) == len(tickets)
for t in tickets:
    assert t["departmentId"] in department_ids
    assert 1 <= len(t["title"]) <= 80
    assert t["status"] in statuses
    assert (t["closedAt"] is not None) == (t["status"] == "closed")

payload = {"generatorVersion": "1", "seed": 42,
           "referenceTime": reference_time,
           "departments": departments, "tickets": tickets}
Path("tickets.valid.json").write_text(
    json.dumps(payload, ensure_ascii=False, indent=2), encoding="utf-8")
这个小脚本只检查列出的规则;如果项目需要邮箱格式、时间顺序或复杂唯一组合,应继续补相应校验。不要关闭Python断言执行来运行这段检查。正式验证器应输出记录id、字段和失败原因,方便定位,而不只是最后显示“数据有误”。
固定种子还不够。生成器代码、依赖版本、调用顺序和参考时间都可能影响结果。Faker使用文档也说明,种子相同但版本变化可能得到不同结果,依赖“今天”的日期生成还需要固定参考日期。交接时可在README记录这些条件和文件校验值,让别人能够重建同一份数据。
别让随机数量取代边界覆盖
生成1000个普通标题,并不意味着会碰巧覆盖80字符和81字符。边界应明确构造,而不是等随机碰运气。可以单独准备“单字符标题”“恰好上限”“超出一个字符”“无效部门”“关闭时间缺失”等具名记录,把预期接受或拒绝结果写在旁边。
| 数据组 | 记录条件 | 预期结果 |
|---|---|---|
| boundary-valid | 标题恰好80字符 | 字段校验通过,页面仍可读 |
| invalid-title | 标题81字符 | 长度规则拒绝,并定位到标题字段 |
| invalid-relation | departmentId为D-MISSING | 关联检查拒绝 |
| invalid-state | status为closed但closedAt为空 | 状态与时间一致性检查拒绝 |
错误集最好一次只违反一个规则,便于验证提示是否准确;另设少量多错误组合检查汇总体验。检验错误集的成功标准是“正确拒绝”,不能因为它没有通过校验就删除它。
给AI的任务说明,包含交付文件和检查方式
请读取字段说明和工单接口定义,先列出不明确或互相冲突的规则。
规则确认后,在 fixtures/ 中创建生成器,不连接生产数据库。
分别生成正常、边界、故意错误三组JSON,并给每组写明用途。
部门先生成,工单只能引用已存在的有效部门;错误集例外要有标记。
固定种子42、参考时间2026-10-05T00:00:00Z,记录运行时与依赖版本。
添加校验:必填、类型、枚举、主键唯一、部门引用、状态与关闭时间一致。
如果执行过校验,保存命令和实际结果;未执行的不要写成通过。
输出README,说明如何重新生成、如何识别预期失败数据。原型展示通常只需要每组中有代表性的几条,不必把整份数据搬进画布。选择一条长标题、一条待处理、一条已关闭和一个空结果,放到墨刀原型对应页面中检查布局与状态;这不等于把JSON自动接入真实后端。开发与测试使用完整数据文件,设计评审使用相同规则的代表项,三方讨论的才是同一种业务情况。
测试数据的价值在于能回答“这个输入为什么在这里”。用墨刀AI客户端整理字段、生成器与校验结果后,先挑一条数据沿界面和接口走完整个动作,再扩大数据规模,更容易发现隐藏在关联和状态之间的问题。