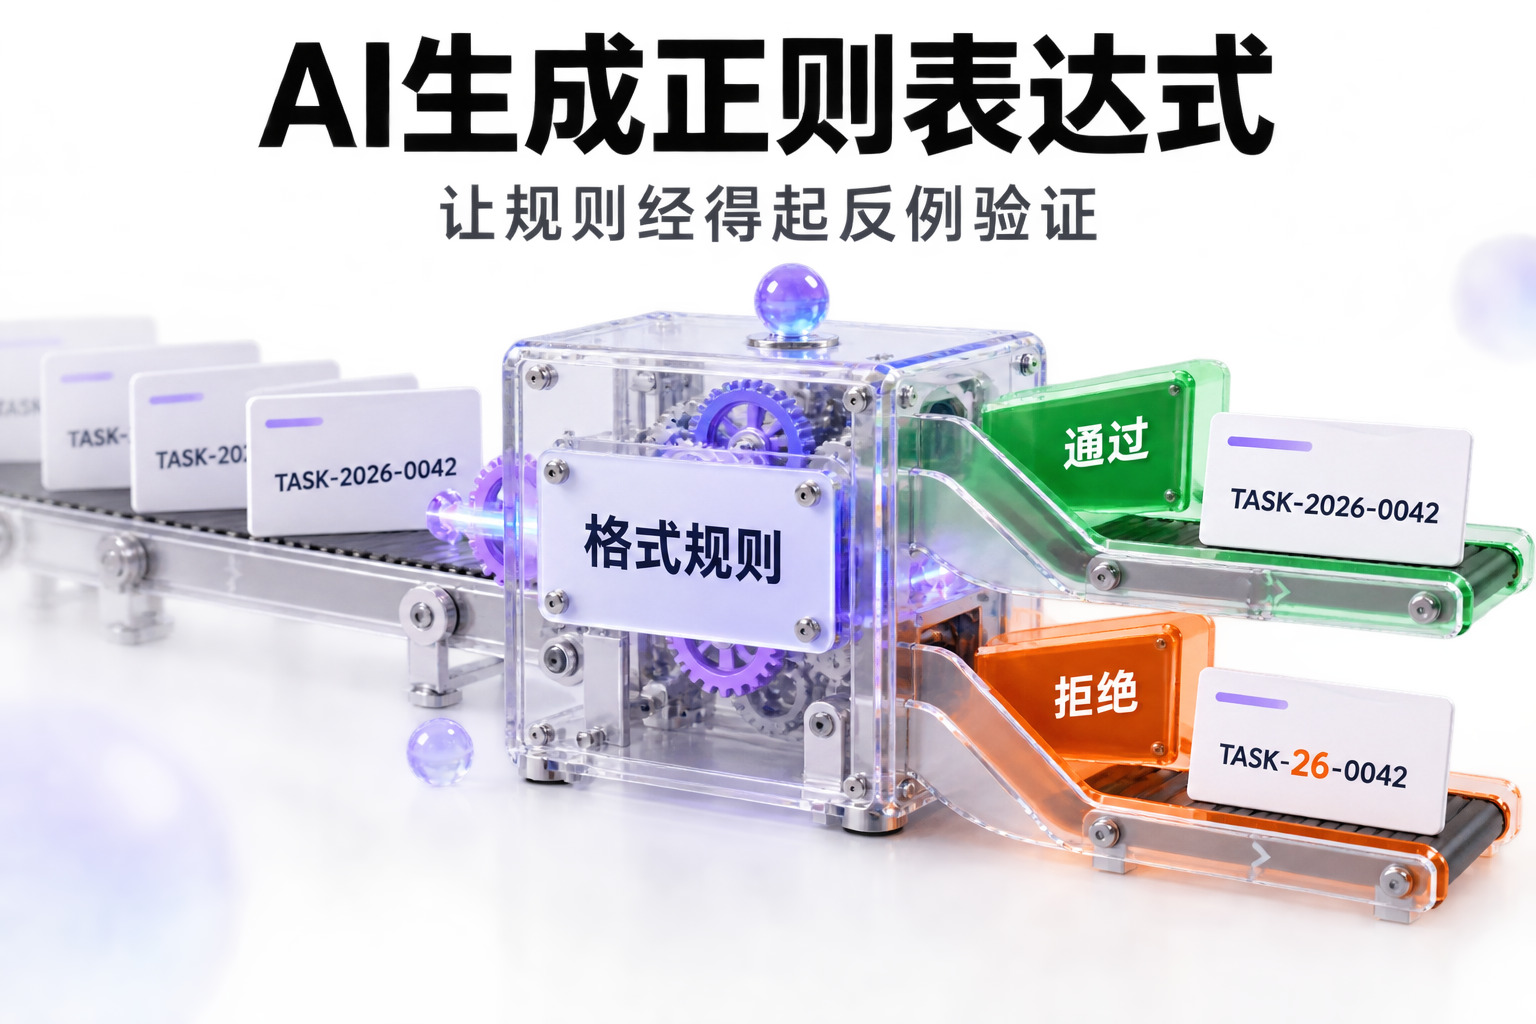
AI生成正则表达式时,先说明运行语言、整串校验还是文本提取,再给出应该通过与必须拒绝的样本。得到表达式后,在实际运行环境里逐条比较预期与结果。只匹配到一个正确编号,无法证明它会拒绝多余前缀、全角数字或换行。
本文用 TASK-2026-0042 这种项目编号演示完整过程:写规则、生成匹配式、运行反例,再处理文本中的多个编号。若资料已经在本地目录,可以用墨刀AI客户端整理规则与代码样本,把规则文件和测试文件放在同一项目中;代码是否正确仍由实际运行结果判断。
先把“像这个编号”变成可以判断的规则
“匹配 TASK-2026-0042”有很多解释:年份是否固定为2026?末尾必须四位吗?前面能不能有说明文字?AI可能按最宽松的解释生成一个看似可用的表达式。先确认这些问题,比生成后不断加补丁更省事。
本例约定:输入必须是字符串,完整内容由大写 TASK、半角连字符、2000至2099之间的四位年份、另一个半角连字符和四位数字构成。末尾允许 0000,不检查编号是否真实存在,也不自动去除空格。年份只是格式范围,不代表这个任务的创建时间已经核实。
| 边界 | 应通过 | 应拒绝 |
|---|---|---|
| 大小写与年份 | TASK-2026-0042 | task-2026-0042、TASK-1999-0042 |
| 末尾位数 | TASK-2000-0000 | TASK-2026-042、TASK-2026-00042 |
| 字符种类 | TASK-2099-9999 | TASK-2026-0042、TASK–2026–0042 |
| 完整输入 | 恰好一个编号 | 前后空格、末尾换行、额外前后缀 |
如果业务希望粘贴时自动清理首尾空格,应把清理设为单独步骤,再校验清理后的值;原始输入与规范化输入要分清。不要让AI悄悄加上 trim(),使规则表里的反例突然变成正例。
让AI同时交出表达式、解释和反例
把上面的规则存为 task-id-rules.md,向AI说明:
请按规则文件生成 JavaScript 编号校验函数。只校验完整字符串;不使用 i、m、g 标记,不自动清理输入。先指出规则歧义,已明确的规则不要自行扩大。输出正则字面量、每段含义、正反样本和可以用 Node.js 运行的验证代码。预期结果来自规则表,不调用被测函数生成预期值。另行说明从正文提取编号时需要补充什么边界约定。
对于本例,表达式可以写成:
const pattern = /^TASK-20[0-9]{2}-[0-9]{4}$/;

function isTaskId(value) {
  return typeof value === 'string' && pattern.test(value);
}
^ 与 $ 在这里约束整个输入,TASK-20 是固定内容,[0-9]{2} 补足年份后两位,最后的 [0-9]{4} 限制编号为四位半角数字。类型判断避免将数字、空值或其他对象当成编号输入;它也让函数的使用约定比单独一个正则更清楚。
不要看到更短的写法就立即替换。去掉锚点后,xTASK-2026-0042 内部也有一个匹配片段;加上 i 会接受小写;加上 m 会让锚点按行工作。MDN的输入边界说明可以用于核对这些语义,切换到其他语言时还要查对应引擎。
把预期写在样本旁边,运行后再接受结果
将上面的函数和以下代码放入同一个 check-task-id.cjs 文件,在已安装Node.js的环境中运行 node check-task-id.cjs。这份样本包含18条输入,其中3条应通过、15条应拒绝。输出不一致时会立即抛出断言错误。
const assert = require('node:assert/strict');
const cases = [
  ['TASK-2026-0042', true], ['TASK-2000-0000', true],
  ['TASK-2099-9999', true], ['task-2026-0042', false],
  ['TASK-1999-0042', false], ['TASK-2100-0042', false],
  ['TASK-2026-042', false], ['TASK-2026-00042', false],
  ['TASK-2026-0042', false], ['TASK–2026–0042', false],
  [' TASK-2026-0042', false], ['TASK-2026-0042 ', false],
  ['TASK-2026-0042\n', false], ['xTASK-2026-0042', false],
  ['TASK-2026-0042x', false], ['', false],
  [null, false], [20260042, false]
];
for (const [value, expected] of cases) {
  const actual = isTaskId(value);
  assert.equal(actual, expected, JSON.stringify(value));
  console.log(JSON.stringify({ value, expected, actual }));
}
console.log(`${cases.length} cases passed`);
上述18条输入已在Node.js v24.19.0中运行,实际结果均与预期相同。这个结果只覆盖所列规则和样本,不代表编号已经在数据库存在,更不代表可以访问它对应的任务。真实性与权限仍需要业务系统判断。
还可以做一次有意的错误检查:临时去掉正则的 ^,再运行这些样本,带前缀的反例应失败。若没有失败,检查是否运行了当前文件,以及断言是否真的比较了预期值。要把这些检查并入现有项目,可参考AI生成单元测试中的规则与断言方法,沿用项目已有测试框架。
从正文提取编号,先约定什么算分隔符
整串校验回答“这一个输入是否合法”;文本提取回答“一段内容里哪些片段是编号”。不能简单地去掉锚点就交付:TASK-2026-0042-extra 内也能截出一个看似正确的编号,却可能是另一个系统的完整标识。
本例采用一个容易解释的提取约定:空白、英文或中文逗号、分号、中文句号和中英文圆括号可以分隔编号。字母、冒号、斜线和连字符不属于分隔符。因此 任务:TASK-2026-0042 不会被提取;若业务需要这种格式,应明确把冒号加入规则并补样本。
function extractTaskIds(text) {
  const candidates = text.split(/[\s,,;;。()()]+/u);
  return candidates.filter(isTaskId);
}
assert.deepEqual(
  extractTaskIds('请处理 TASK-2026-0042,复核 TASK-2026-0043。'),
  ['TASK-2026-0042', 'TASK-2026-0043']
);
assert.deepEqual(
  extractTaskIds('xTASK-2026-0042 TASK-2026-0042-extra TASK-2026-0042'),
  []
);
assert.deepEqual(
  extractTaskIds('(TASK-2026-0042);TASK-2099-9999\nTASK-2000-0000'),
  ['TASK-2026-0042', 'TASK-2099-9999', 'TASK-2000-0000']
);
这3组提取样本也已在同一Node.js环境运行通过。这里保留出现顺序和重复编号,不返回字符位置。需要去重、定位或替换时,应单独约定输出;尤其不要把“提取到编号”直接升级为批量修改原文。
两种常见复制错误:转义和有状态标记
JavaScript正则字面量与字符串构造器不是同一种书写环境。使用 \d 表示数字时,字面量可写 /^TASK-20\d{2}-\d{4}$/;构造器字符串里则需要 new RegExp('^TASK-20\\d{2}-\\d{4}$')。反斜杠先经过字符串解析,再进入正则解析。详情见MDN的RegExp参考。
另一个问题来自 g:同一个带全局标记的正则对象会维护 lastIndex。本例对相同编号连续调用两次带 g 的 test(),实际得到 true、false。普通字段合法性判断不需要全局搜索,去掉 g 更直接,不要在业务代码里靠反复重置状态掩盖误用。
若AI返回了嵌套量词或大段可选分支,先要求解释最坏输入如何退出。本例是固定长度模式,没有必要为它引入复杂回溯结构。正式系统仍应限制字段长度;本文额外运行了一个带10万位数字的超长反例并确认拒绝,但没有进行性能基准测试。
交付时把适用范围留在代码旁
保存表达式时,一并留下运行语言、flags、规则文件和正反样本。规则以后变成“支持BUG前缀”或“年份允许2100”时,先改约定与预期,再改实现,这样评审者能看到行为为什么变化。
如果要把这类小任务纳入固定工作方式,可从墨刀AI客户端使用指南了解本地项目组织。对正则本身,最有用的交付不是一句“生成成功”,而是团队能继续运行的样本,以及它明确拒绝什么、尚未覆盖什么。