测试单独运行通过,放进整套测试却偶尔失败,先比较它前后运行了谁。若改变顺序就能稳定改变结果,问题可能来自某个测试留下的共享状态。让AI排查时,给它可重现的运行顺序、被修改的状态和失败断言,比只贴一段红色日志更容易缩小范围。
下面用地区配置影响币种的例子,实际复现一次顺序依赖。可以在墨刀AI客户端整理失败日志与最小复现任务,把候选原因转成可执行的检查。本文结果来自本地Python测试运行,展示如何从“偶尔失败”走到能解释的修复。
先留下“怎样运行才失败”的证据
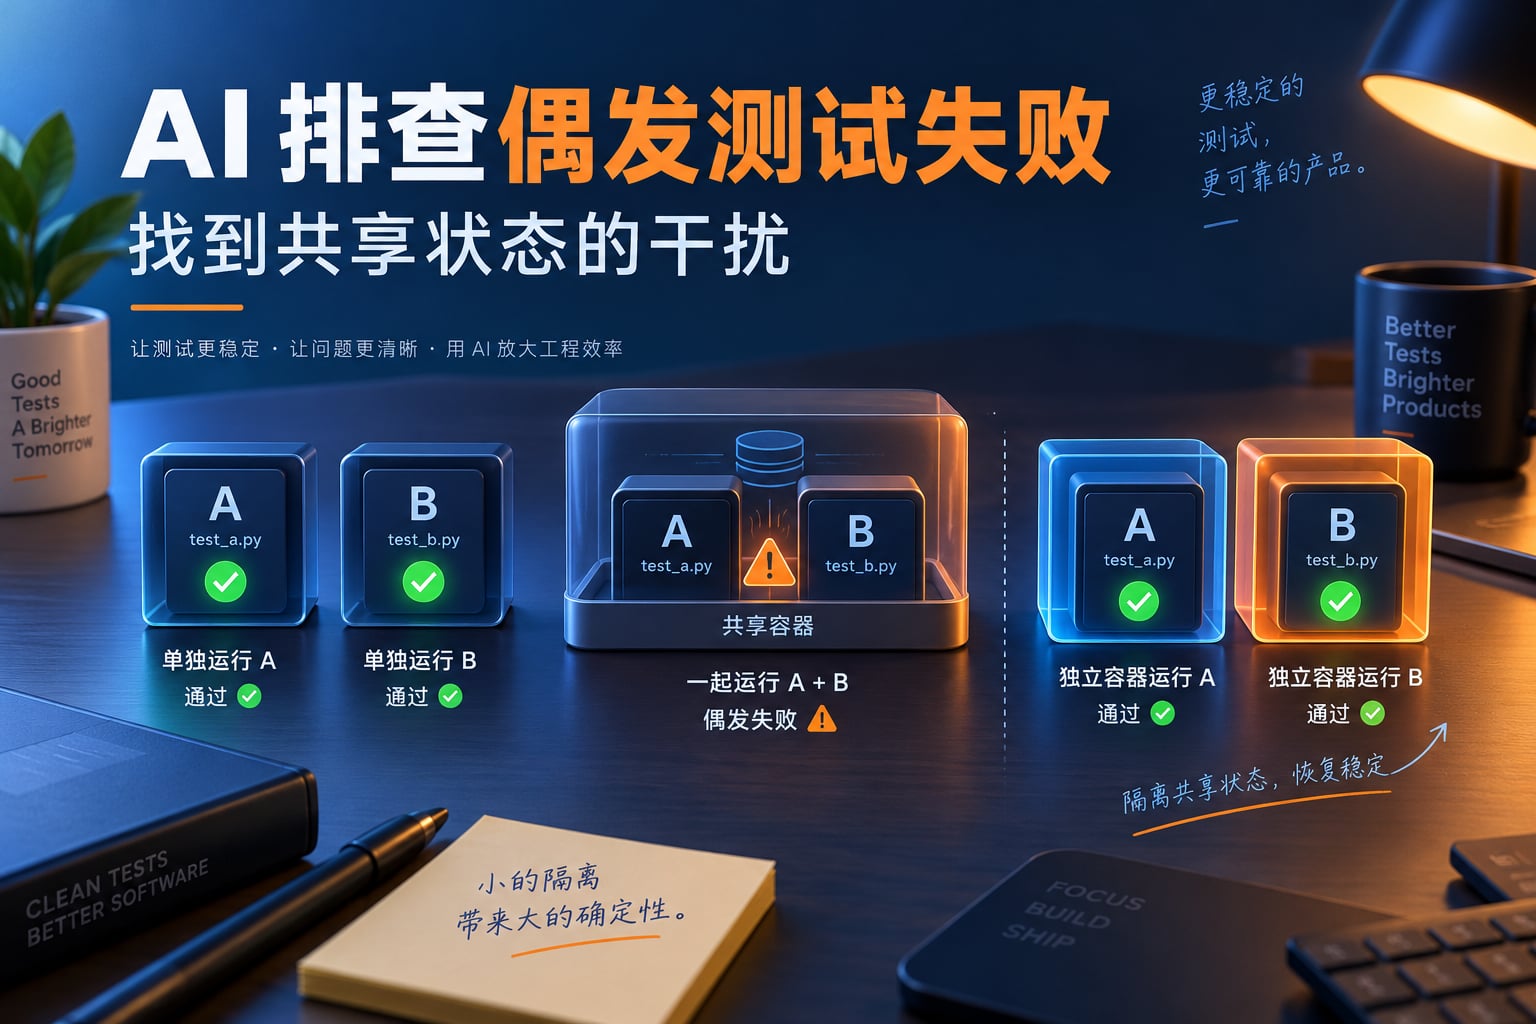
本例应用有一个全局字典SETTINGS,地区默认为CN,currency函数因此返回CNY。测试A将地区改成US,检查得到USD;测试B检查默认地区对应CNY。两条断言单看都合理,问题是A修改后没有恢复字典。
如果只运行B,它通过;先A后B,B读到残留的US就失败;先B后A,两条又都通过。这种现象在整套测试排列或分组变化时,看起来可能很随机,但当前例子的触发条件是确定的。
给AI的材料应至少包括两个测试、currency函数、SETTINGS定义、实际顺序和断言差异。任务可以写成:“请先解释为什么A→B与B→A结果不同,指出具体写入者和读取者,再给出隔离方案。保留B期待CNY的业务断言,不把重试或调整顺序当成修复。”
用一份脚本对照修复前后的两种顺序
下面只用Python标准库unittest。run_case会在每组实验前重置全局配置,保证不同组之间互不干扰;同一组内是否清理状态,则由测试类决定。这样才能把原因限定在一组测试之间,而不是让上一轮实验污染下一轮。
保存为flaky_demo.py并执行python flaky_demo.py。脚本会运行一个预期失败的实验,并在最终结果中验证这个失败确实出现。因此最后进程正常结束,不代表修复前的所有测试都通过。请勿使用会移除断言的Python优化选项。
import io
import json
import unittest

SETTINGS = {'region': 'CN'}


def currency():
    return 'CNY' if SETTINGS['region'] == 'CN' else 'USD'


class LeakyTests(unittest.TestCase):
    def test_us_region(self):
        SETTINGS['region'] = 'US'
        self.assertEqual(currency(), 'USD')

    def test_default_region(self):
        self.assertEqual(currency(), 'CNY')


class IsolatedTests(LeakyTests):
    def setUp(self):
        original = SETTINGS.copy()
        self.addCleanup(self.restore, original)
        SETTINGS.clear()
        SETTINGS.update(region='CN')

    @staticmethod
    def restore(original):
        SETTINGS.clear()
        SETTINGS.update(original)


def run_case(cls, names):
    SETTINGS.clear()
    SETTINGS.update(region='CN')
    suite = unittest.TestSuite(cls(name) for name in names)
    output = io.StringIO()
    result = unittest.TextTestRunner(stream=output, verbosity=2).run(suite)
    return {'tests': result.testsRun, 'failures': len(result.failures),
            'errors': len(result.errors), 'log': output.getvalue()}


orders = [ ['test_us_region', 'test_default_region'],
           ['test_default_region', 'test_us_region'] ]
report = {
    'alone': run_case(LeakyTests, ['test_default_region']),
    'before_forward': run_case(LeakyTests, orders[0]),
    'before_reverse': run_case(LeakyTests, orders[1]),
    'after_forward': run_case(IsolatedTests, orders[0]),
    'after_reverse': run_case(IsolatedTests, orders[1]),
}
assert report['alone']['failures'] == 0
assert report['before_forward']['failures'] == 1
assert report['before_reverse']['failures'] == 0
assert report['after_forward']['failures'] == 0
assert report['after_reverse']['failures'] == 0
assert all(row['errors'] == 0 for row in report.values())
assert SETTINGS == {'region': 'CN'}
print(json.dumps(report, ensure_ascii=False, indent=2))
| 本地运行场景 | 测试数 | 失败数 | 说明 |
|---|---|---|---|
| 单独运行默认地区测试 | 1 | 0 | 初始环境为CN |
| 修复前:US测试 → 默认地区测试 | 2 | 1 | 后者得到USD,期望CNY |
| 修复前:默认地区测试 → US测试 | 2 | 0 | 污染发生在最后,暂未影响其他测试 |
| 隔离后:US测试 → 默认地区测试 | 2 | 0 | 每条测试从约定基线开始 |
| 隔离后:默认地区测试 → US测试 | 2 | 0 | 换序仍通过,结束后配置恢复 |
这份记录支持的结论很具体:本例失败来自前一个测试修改了SETTINGS,给每条测试设置基线并清理后,两种顺序都通过。它不能证明项目所有偶发失败都与全局字典有关,也没有覆盖多进程或多线程竞争。
修复要有测试前的基线,也有测试后的清理
IsolatedTests在setUp中保存进入测试前的配置,登记清理动作,再设定本例所需的CN基线。结束时清理函数先清空字典,再恢复原内容,避免测试新增的其他键留在对象里。只把region重新赋成CN,可能遗漏后来加进来的字段。
这里使用unittest的addCleanup机制,让登记的恢复操作在测试生命周期结束时执行。测试抛出异常时仍应有清理机会,不能把恢复语句简单写在最后一个断言之后,因为失败会跳过后续普通语句。
本例配置只有一层字符串值,所以copy足够。若共享对象包含嵌套列表,浅拷贝仍可能引用同一份内部数据,需要按实际结构隔离。更进一步,可以让被测函数显式接收配置对象,使每条测试创建自己的输入,减少对全局状态的依赖;这属于代码设计调整,需要同时评估调用方。
回到真实项目,按写入者寻找相同模式
pytest关于偶发测试的说明把系统状态控制不足列为常见原因。即使用的不是pytest,这个排查方向仍有帮助:先列出失败测试读取的共享资源,再追溯谁会修改它。
| 共享资源 | 应找的写入 | 可验证的处理 |
|---|---|---|
| 环境变量或地区配置 | 测试中覆盖值但未恢复 | 登记原值与是否存在,结束后恢复原状态 |
| 模块缓存 | 前一测试初始化了其他用户的数据 | 每例使用独立实例或明确清缓存 |
| 临时文件目录 | 多条测试共用固定文件名 | 每例独立目录,并验证不会读取上例文件 |
| 数据库记录 | 测试留下了同一业务编号 | 隔离数据范围,并检查清理或事务边界 |
不要一次修改所有候选原因。先保留能触发失败的最小测试对,记录共享值在A前、A后和B读取时分别是什么。若证据不随顺序变化,应回到其他假设,例如时间、依赖服务或资源竞争;可以继续用CI失败的环境与执行阶段排查方法扩大范围。
把触发条件留在修复说明里
提交说明应写明:A修改了什么,B依赖哪个初始值,原先缺了哪项清理,以及修复后检验了哪些顺序。把失败前后的输出与脚本版本一起保存,后续重构时才知道隔离代码为什么存在。
重复运行到绿色不能代替这个解释;固定成B先执行,也只是让残留状态暂时不伤害B。若需要补充新的业务断言,可参考从已有代码生成有意义的单元测试。这一次修复完成的标志,是原来会暴露问题的顺序仍然被检查,而它已经不会改变测试的业务结果。