用AI整理用户反馈,难点不是把几十条意见压缩成几段总结,而是保留足够的证据,让团队知道谁在什么任务中遇到什么阻碍。先给原始记录编号、区分重复转发与独立事件,再归类主题;每个主题都应能回到原话,同时保留不支持当前判断的记录。
客服导出、访谈记录和表格分散在本地文件时,可以用墨刀AI客户端整理反馈文件与需求证据,让AI辅助建立索引、提出分类并汇总待确认问题。不要一开始就让它输出“十大痛点”和需求排期,输入里未包含的信息不会因为结论写得整齐而变成事实。
先保留原始记录,再处理重复
准备一份feedback.csv,至少包含记录ID、来源、日期、脱敏用户ID、事件ID、用户任务和原文。来源可以写客服工单、访谈或社群,但不要用渠道名称代替用户身份。同一个人可能通过多个渠道讲同一件事,也可能在不同日期遇到两次问题。
下面这组课程报名记录用于演练。它们的用途是展示归类中的判断,不代表实际调研结论或真实用户比例。
| 记录 | 用户/事件 | 反馈原文 | 需要保留的区别 |
|---|---|---|---|
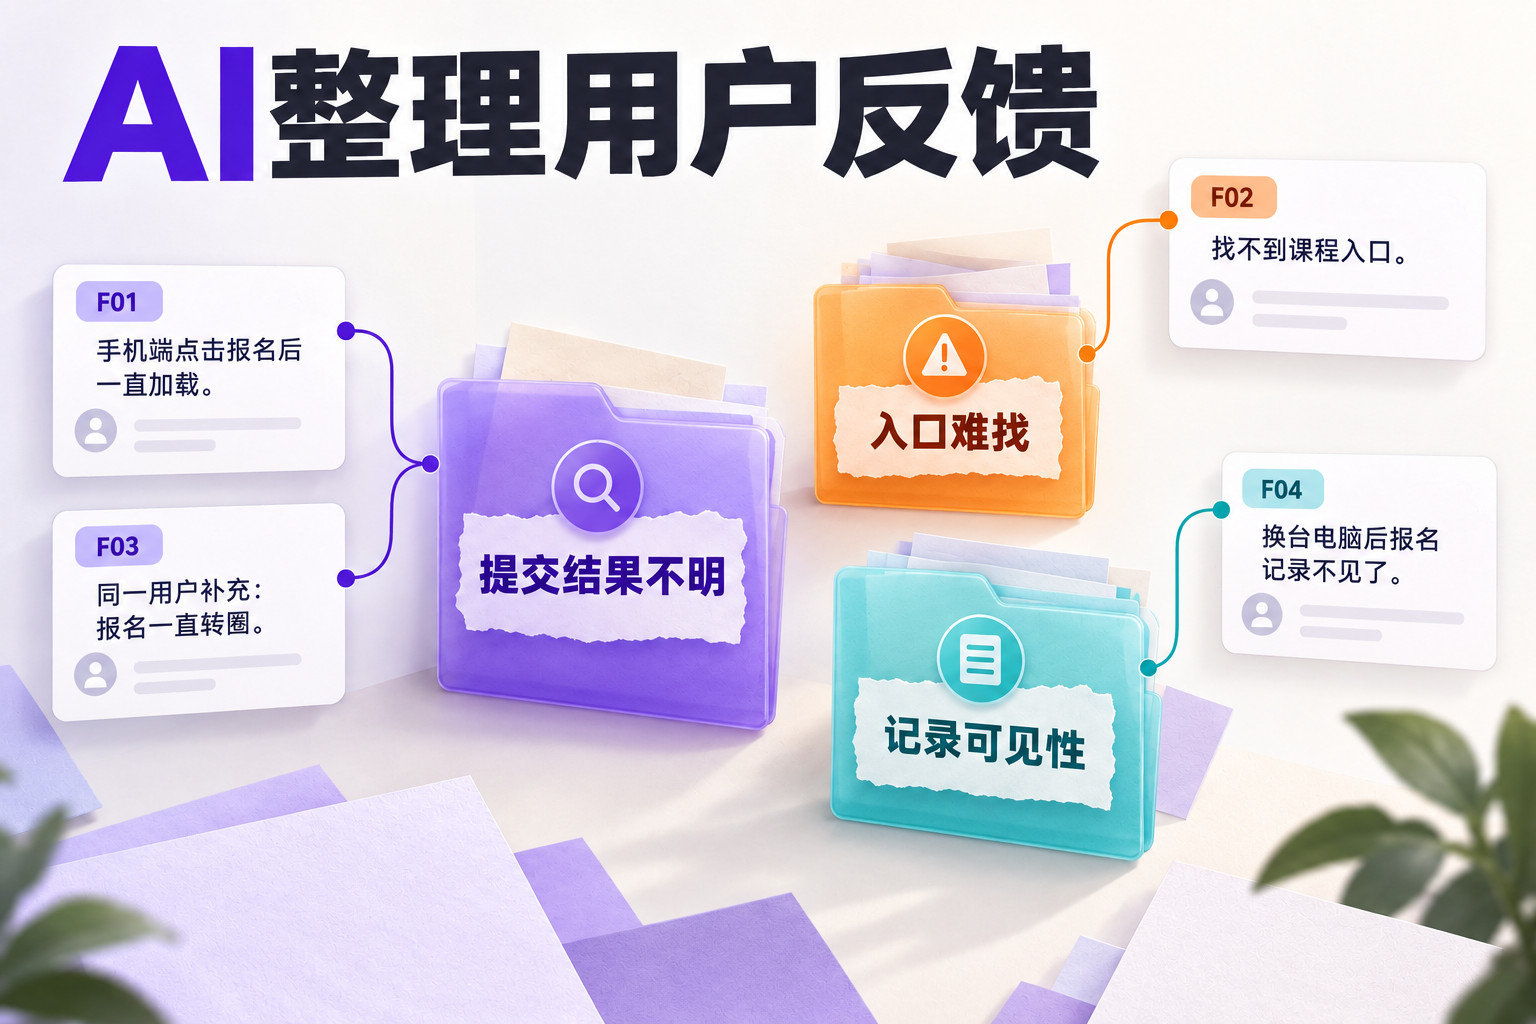
| F01 | U01/E01 | 点了报名没有反应,我又点了一次,不知道成功没有。 | 报名结果不明确 |
| F02 | U02/E02 | 页面提示报名成功,但我找不到上课链接。 | 已经知道成功,找不到下一步 |
| F03 | U01/E01 | 客服转发:点报名没反应,重复点了两次。 | 与F01是同一事件的转发 |
| F04 | U03/E03 | 我在手机上报了名,电脑上登录以后课程列表里没有。 | 跨端定位问题,原因待确认 |
| F05 | U04/E04 | 能否把上课时间加入日历?我经常忘记。 | 明确方案请求,背后是记忆负担 |
| F06 | U05/E05 | 确认页很清楚,我直接从那里进入了课堂。 | 正向记录,可用于查找条件差异 |
| F07 | U06/E06 | 付款后一直显示处理中,刷新以后才看到成功。 | 结果等待问题,涉及支付不能混同普通提交 |
| F08 | U07/E07 | 课程卡片只写课程名称,两场同名课分不清时间。 | 场次辨认困难 |
这8条记录涉及7名用户、7个事件,F01和F03属于同一用户的同一事件。如果按记录数直接统计,重复转发会放大问题;如果只按用户数,又会漏掉同一用户反复遇到问题的频率。报告需要明确自己在数记录、用户还是事件,三种数可以并存,但不能混用。
去重不是删除措辞相近的句子
先用明确证据建立重复关系:原工单号、相同事件ID、转发链或人工确认。将F03标记为F01的关联记录,保留原文与来源,汇总事件时只计一次。若只是措辞相似,最多标为“疑似重复待核对”,不能直接合并。
F01和F07都说“不知道成功没有”,却不能当成同一问题删掉一个。前者可能是提交无反馈,后者处在支付后的处理状态,风险与技术链路不同。可以归到共同上层主题“结果不确定”,但保留子问题、操作阶段和各自事件。
F02与F04也不应立刻统一为“课程丢失”。F02明确报名成功,只是找不到链接;F04还需要核对账号、场次、列表筛选和同步情况。主题越宽,越要在下面保留这些差异,否则团队可能为几种不同问题开发一个都不对症的方案。
给行为和阻碍编码,别只分正面负面
一条反馈可以有多个标签:用户任务、所处阶段、观察到的现象、希望达到的结果、待核实原因。先标记能从原话直接确认的部分,再提出解释。不要把“用户说找不到”自动转写成“系统未同步”,后者是尚未证实的原因。
例如F04可以标记“查找已报名课程”“跨设备”“列表未找到”“原因待核对”;F05可以标记“记住上课时间”“提醒需求”“提出日历方案”。这样既能看到用户想做的事,也不会把用户提出的某个功能直接当成唯一解法。
NN/g的主题分析方法强调从材料编码、形成主题并回看原始数据。实际执行时,可以让AI先给候选标签,再由研究者调整定义。尤其要检查同一标签是否一直指同一种现象,不能前半部分用“登录问题”表示忘记密码,后半部分又表示账号权限不够。
把主题汇总成能追问的证据表
| 候选主题 | 证据 | 目前能说什么 | 还不能说什么 |
|---|---|---|---|
| 操作后结果不确定 | F01、F03、F07;合并后2个事件 | 两类操作都出现结果确认困难 | 不能断定都由按钮无反馈造成 |
| 报名后难以找到下一步 | F02、F04、F08 | 链接、跨端列表和场次辨认分别存在阻碍 | 不能合并成同一个系统故障 |
| 担心忘记上课时间 | F05 | 出现提醒需求和日历方案请求 | 不能推断大多数用户需要日历集成 |
| 确认页路径在部分条件下有效 | F06 | 至少这条记录中确认页能帮助继续 | 不能据此否定其他人的困难 |
每个主题后面都写一个待补问问题,比再添一个笼统建议更有用。结果不确定的用户当时看到了什么?报名后能顺利进入课堂的人使用了哪种入口?两场同名课有哪些信息能帮助区分?这些问题会把下一轮访谈、日志查询或原型验证连接起来。
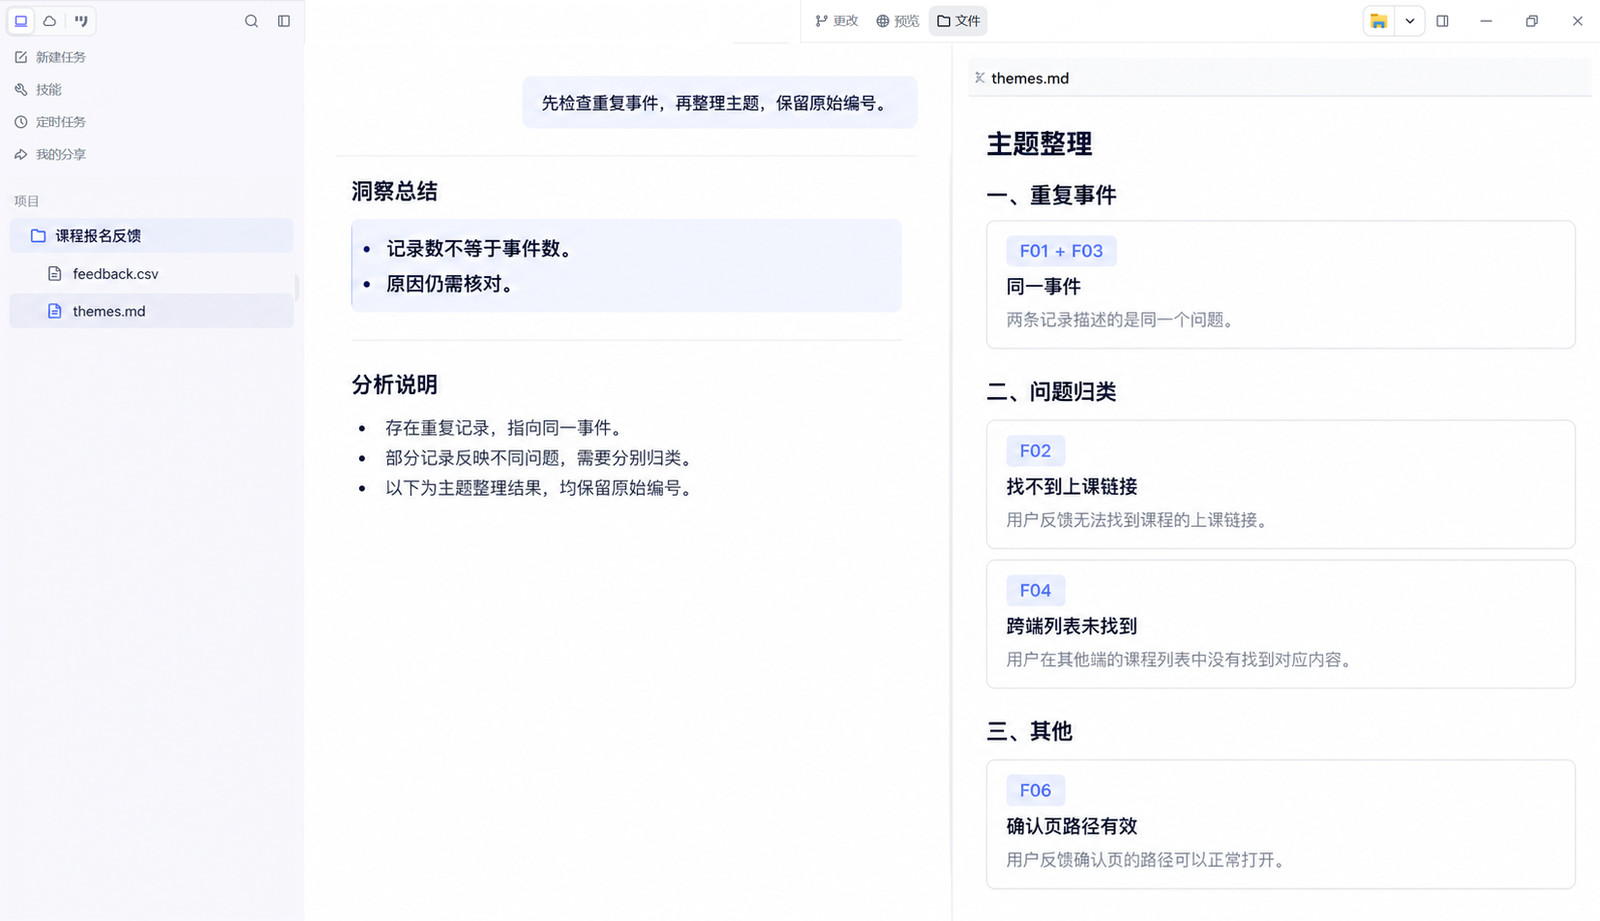
给AI的任务说明与输出文件
原始文件保持只读,将标签定义放在codebook.md,输出保存在新文件里。可以使用下面的任务说明:
读取feedback.csv。保留每条记录ID和原文,先检查缺失字段及疑似重复,不自行删除记录。按照“任务—阶段—现象—期望结果—待核实原因”提出标签;一条允许多标签。明确区分事实、用户主张和你的推测。输出coded-feedback.csv及themes.md。每个主题列出来源ID、合并后的事件数、用户数、反向记录和待补问问题。不要生成需求优先级或虚构用户比例。先用前8条试标,标签确认后再继续全量。
试标的意义是及早发现分类偏差。若第一批把“付费失败”和“付费后状态延迟”全贴成“支付问题”,后续即使处理得再快,也只会批量复制含糊结论。确认标签后,在定义文件中写一条例子和一条不应包含的情况,后续更新才有一致标准。
如果记录中有联系方式、订单号或不必要的身份信息,先生成适合当前分析任务的脱敏副本。把不同文件中的同一用户使用同一匿名ID,既便于去重,也能减少将无关个人信息带入分析的需要。
如何抽查,如何进入需求讨论
抽查不要只随机挑最清楚的几条。优先查看所有重复合并、数量较多的主题、含多个问题的长反馈,以及“无法归类”的记录。每个主要主题至少反查代表原文与相反证据,确认AI没有把原话中的“可能”“这一次”改写成确定且普遍的判断。
若某条被分到多个主题,主题数量相加可能大于记录数,这是多标签的正常结果,但报告中要说明计数方式。样本来自主动投诉、客服或特定渠道时,也不能用它估算全体用户的发生率;要判断普遍程度,应结合产品使用数据和补充研究。
整理完成后,交给团队的是“问题、证据、未知点和下一步验证”,而不是AI算出的伪精确优先级。影响任务能否完成、是否涉及交易或关键业务、有没有替代路径、验证成本多大,都需要产品与研发一起判断。确认值得推进的事项,再进入需求池的评估与排期流程。
如果证据指向一个可重复的具体故障,可以进一步整理为带复现条件的Bug报告;如果仍有多种解释,先补问而不是先立项。保留这种分流,AI整理反馈才会缩短理解问题的时间,而不是让团队更快讨论一个被错误概括的问题。