核心结论:AI生成原型的可用性测试,不是让参与者评价“页面好不好看”,而是给目标用户一个接近真实场景的任务,观察他能否找到入口、理解信息、完成关键操作并在出错后继续。一次有效测试至少需要测试目标、可操作原型、参与者、任务脚本、观察记录和问题分级六项产物。
本文适合产品经理、UX设计师和需要快速验证方案的创业团队。原型刚完成首轮生成时,可先按AI原型五轮迭代方法校准任务、结构与状态;当核心路径已经能点击,再用本文的方法判断它是否真的可用。
先定义这次AI原型可用性测试要验证什么
测试目标应写成可观察的问题,例如“新用户能否在3分钟内完成退款申请,并知道提交后的处理状态”。不要写“验证页面体验”“看看是否符合预期”,这类目标无法决定任务、记录项和通过条件。
每轮测试只选一到三个高风险任务。优先验证使用频率高、业务后果重、团队争议大或AI容易自行补全的部分。若页面和规则仍来自分散需求,可以先对照PRD转可评审原型的方法确认角色、页面、流程和状态来源,再开始招募参与者。
| 模糊目标 | 可测试目标 | 需要记录 |
|---|---|---|
| 看看筛选好不好用 | 采购专员能否找到本月5万元以上的待审批申请 | 入口、筛选条件、完成时间、错误 |
| 验证错误提示 | 附件上传失败后,用户能否保留表单并重新提交 | 是否理解原因、是否找到恢复动作 |
| 确认信息清晰 | 审批人能否判断金额来源并做出同意或驳回决定 | 阅读顺序、疑问、缺失字段 |
把AI初稿整理成可测试原型
可测试不等于高保真,但必须能完成目标任务。入口、关键页面、按钮反馈、成功结果和至少一种失败恢复路径要连通;演示数据应接近真实长度;尚未确认的规则必须标明为假设,不能让主持人临场解释。
可以用AI生成可编辑原型搭出核心路径,再手动检查跳转、字段和状态。测试前由不参与设计的人走一遍,排除链接断开、页面打不开、明显占位文本等“原型故障”,避免把制作问题误判为用户问题。
- 只保留本轮任务需要的页面,隐藏未完成入口。
- 准备固定起始页和可重复的初始数据。
- 正常、空、错、加载、无权限等状态只展示与任务有关的部分。
- 为主持人准备重置方式,保证每位参与者从相同条件开始。
任务脚本怎么写才不会提示答案
好的任务脚本包含背景、目标和完成信号,但不直接说按钮名称、页面位置或操作顺序。例如不要写“点击右上角筛选,选择金额大于5万”,应写“你需要找出本月金额超过5万元、仍待你处理的申请,并打开其中最早提交的一笔”。
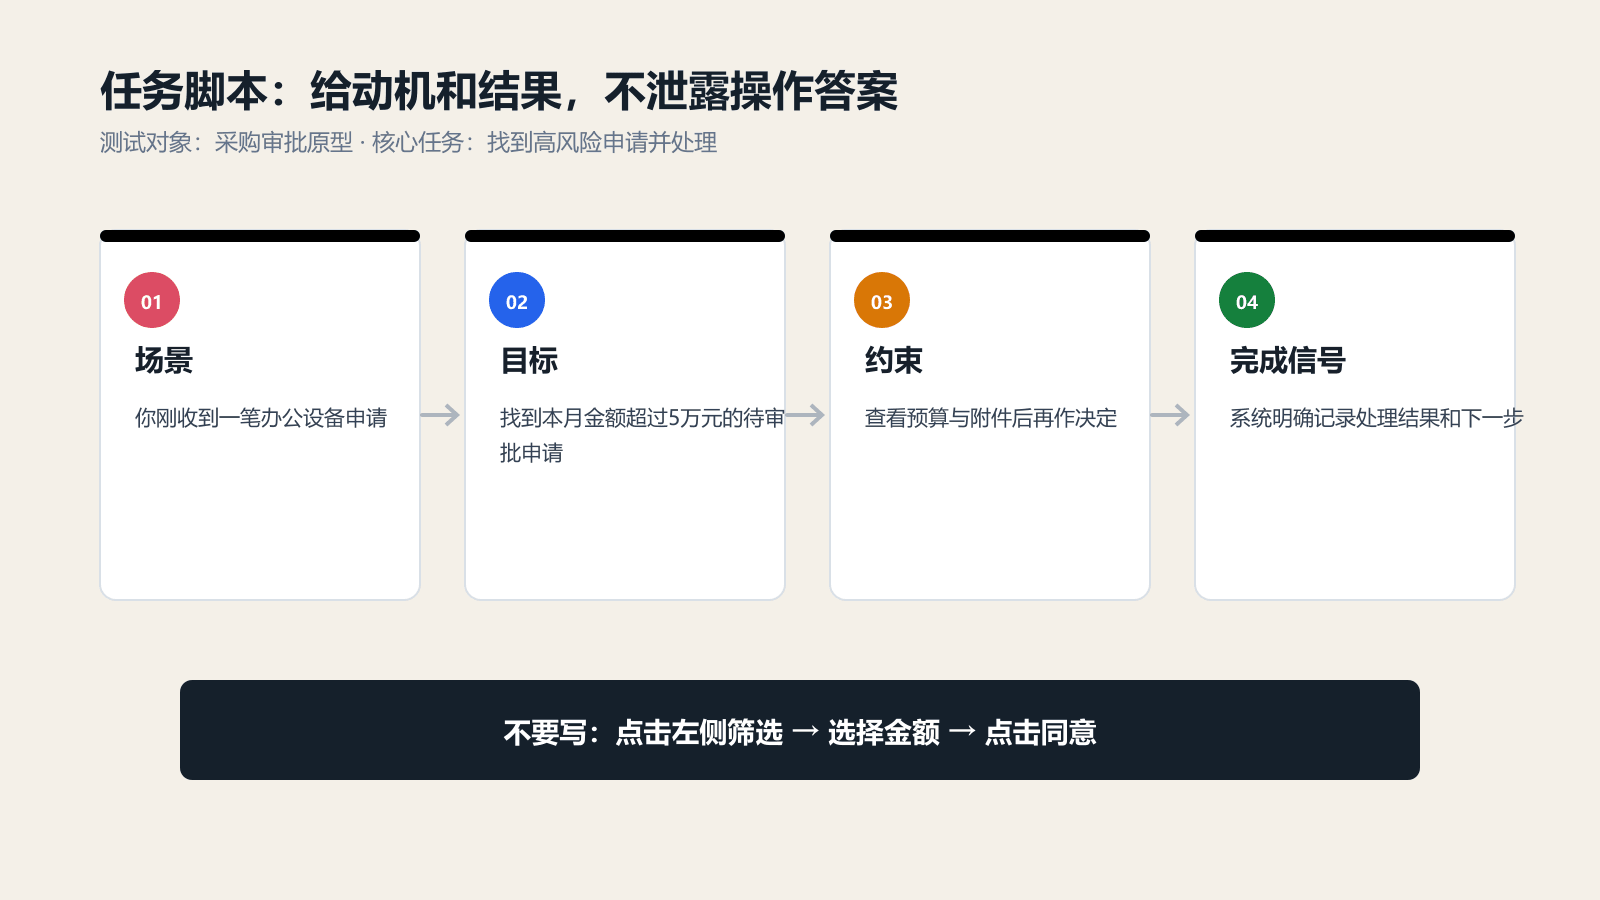
示例任务:你是采购专员,刚收到一笔办公设备申请。请找到本月金额超过5万元、仍待你审批的申请,查看预算与附件,选择合适处理结果,并确认系统已经记录你的决定。
脚本后面另写主持人检查项:起点在哪里、什么算完成、允许提供哪些中性提醒、何时终止。提醒只能复述目标,例如“请继续按你认为自然的方式操作”,不能说“那个入口在左侧”。
参与者和场次应该怎么安排
参与者要符合目标角色,而不是随手找熟悉项目的同事代替。新用户任务要找没有使用经验的人;专业后台要确认参与者是否理解真实业务。小轮次的价值在于尽早发现主要障碍并继续迭代,不应把少量测试结果包装成全体用户的统计结论。
每场可安排一名主持人和一名记录者。主持人说明“我们测试的是原型,不是测试你”,提醒参与者边做边说;记录者只记录行为、原话和界面位置,不在现场讨论解决方案。涉及账号、客户数据或内部流程时,使用脱敏内容并说明录屏范围。
观察时记录行为,不要替用户解释
记录表应把事实与解释分开。事实是“参与者在列表顶部停留20秒,两次打开错误筛选项”;解释是“筛选入口不明显”。先保留事实和原话,测试后再由团队归因,能减少观察者把个人判断写成用户结论。
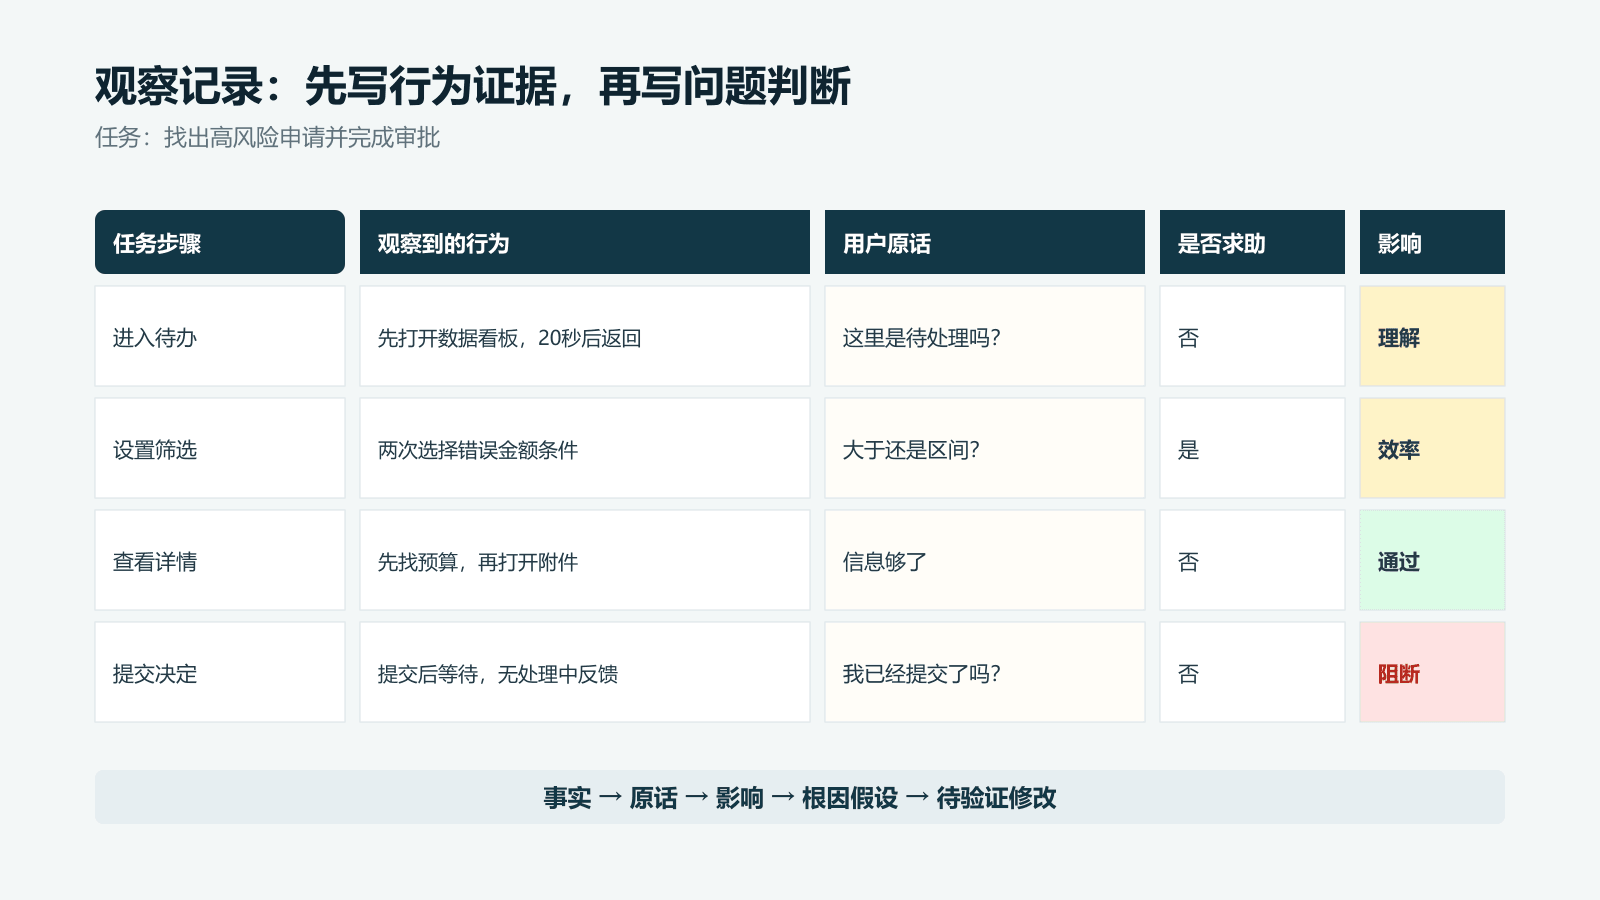
建议记录任务是否完成、完成路径、明显停顿、误点、返回、求助、对状态的理解和失败后的恢复方式。时间可以帮助比较同一任务的迭代版本,但不能脱离任务难度和参与者背景单独判断好坏。
把发现整理成可修改的问题清单
测试结束后,不要直接把所有评论变成修改需求。先合并同一根因,再用“问题发生在哪里、用户想完成什么、观察到什么、造成什么影响、建议验证什么”描述。优先级可综合任务是否中断、影响范围、业务风险和恢复难度。
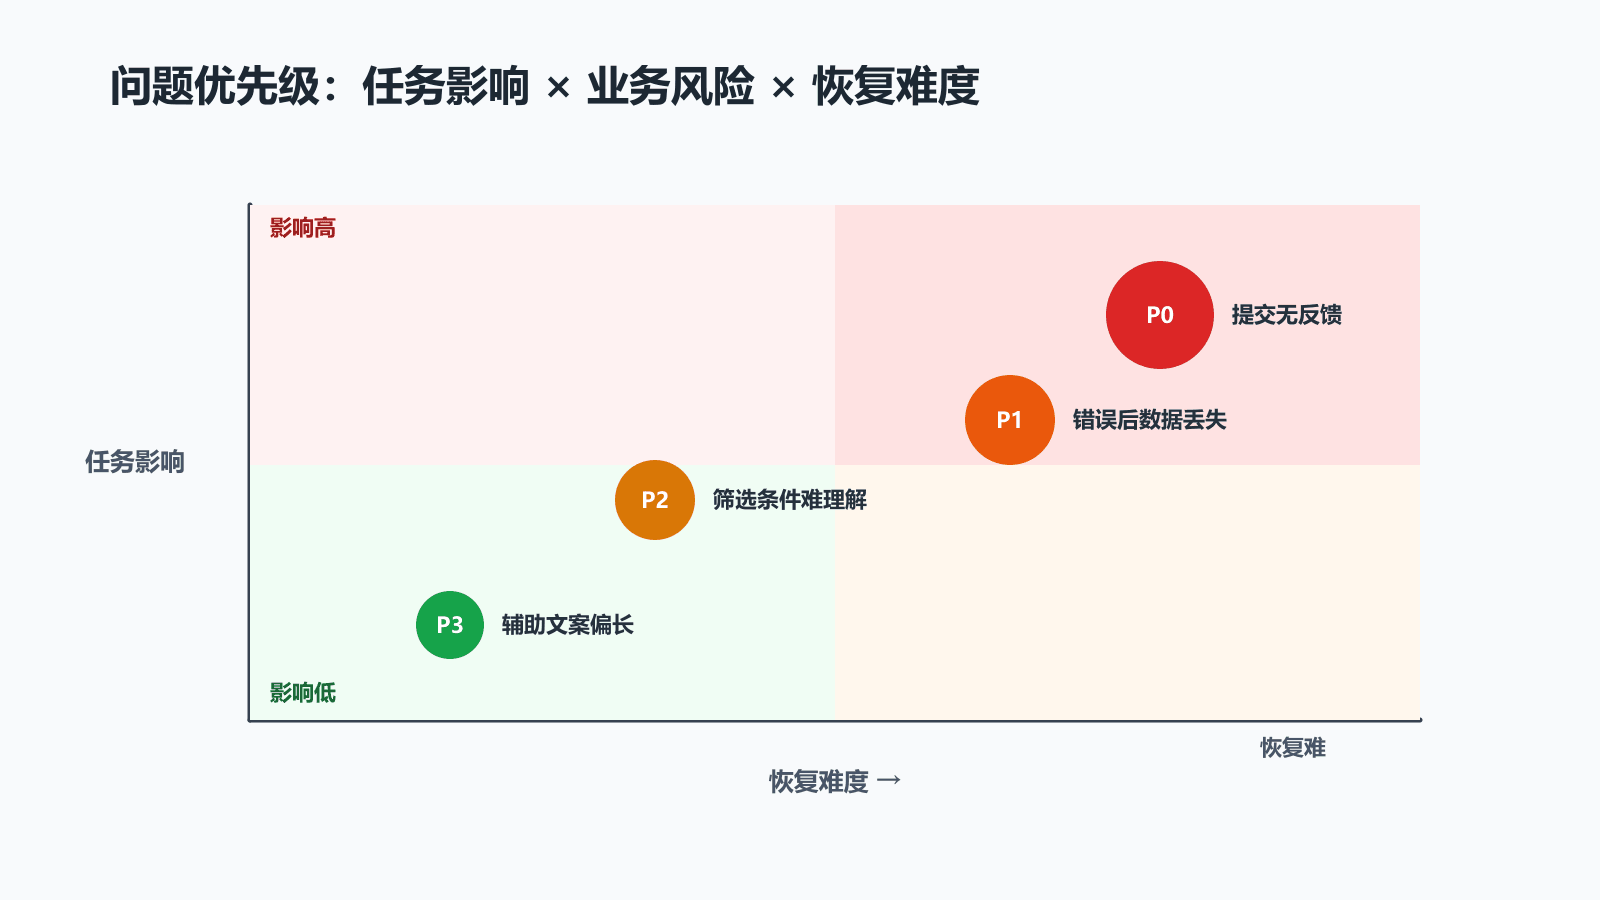
| 等级 | 判断 | 处理方式 |
|---|---|---|
| P0 阻断 | 核心任务无法完成,且没有替代路径 | 修复后重新测试,不进入评审 |
| P1 严重 | 需要帮助才能完成,或可能造成高风险错误 | 本轮修复并验证关键路径 |
| P2 一般 | 任务可完成,但理解或操作成本明显偏高 | 纳入迭代并观察复现 |
| P3 优化 | 不影响结果的局部表达和视觉问题 | 结合规范统一处理 |
问题修复时可参考后台系统状态设计方法补齐空、错、加载、无权限与恢复动作;修改后必须用原任务复测,不能只看新页面是否更整齐。
AI原型可用性测试检查清单
- 测试目标是否能用用户行为和结果判断?
- 每个任务是否有真实场景、目标和完成信号?
- 脚本是否避免按钮名、位置和操作顺序提示?
- 参与者是否符合目标用户角色和经验?
- 原型是否能从固定起点走到成功或失败结果?
- 记录是否区分行为事实、用户原话和团队解释?
- 问题是否说明位置、证据、影响和优先级?
- 高优先级问题修复后是否用同一任务复测?
常见问题
AI生成原型做到什么程度才能测试?
核心任务能点击完成即可,不必等待全部视觉细节。关键是入口、主要信息、操作反馈和结果状态真实到足以触发用户判断。
可用性测试和原型评审有什么区别?
可用性测试观察目标用户能否完成任务;原型评审由产品、设计、研发和业务核对需求、规则与实现边界。前者提供用户行为证据,后者形成团队决策。测试发现进入评审时,可沿用产品原型评审流程明确责任人与处理结论。
主持人可以回答参与者的问题吗?
可以澄清测试背景和任务目标,但不应提示界面操作。若必须帮助才能继续,应记录帮助发生的位置和内容,因为这本身就是可用性问题证据。
AI能快速生成多个方案,但只有真实任务能告诉团队哪个方案更容易被用户理解和完成。把测试目标、脚本、观察证据和问题分级固定下来,每次生成与修改才会从主观讨论变成可复查的产品学习。